 mousePDF
המרת PDF לWord — ללא העלאה, בלי חשבון
ייצוא טקסט PDF כקובץ Word הניתן לעריכה (.docx). ההמרה מתבצעת בדפדפן, הקובץ שלך לא מועלה לשום מקום.
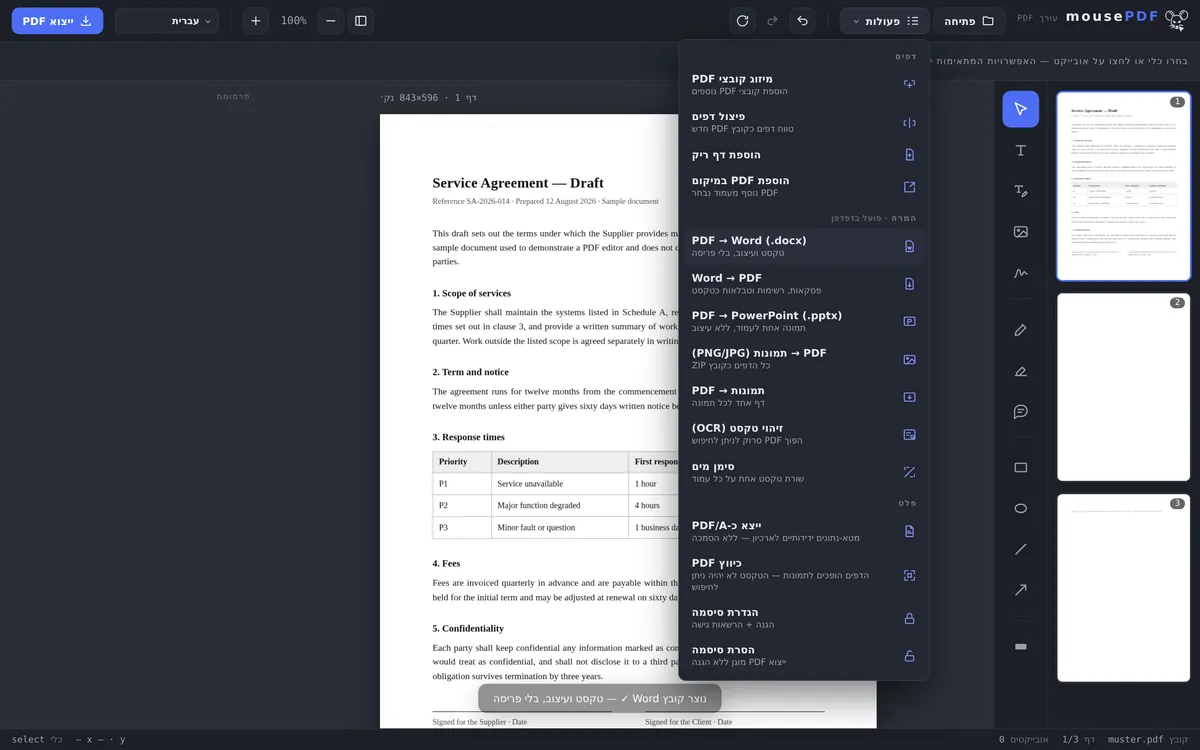
בשלושה שלבים
פתיחת PDF
גרור PDF או פתח דרך חלון בחירת הקבצים.
בחירת "PDF → Word"
בתפריט "המרה" התחל את המרת ה-Word.
שמירת קובץ Word
הורד ישירות את קובץ ה-.docx המוכן.
מה ההמרה שומרת — ומה לא
mousePDF מעביר את הטקסט והעיצוב הבסיסי (למשל פסקאות) מה-PDF לקובץ ה-Word. מה שלא עובר הוא הפריסה המדויקת של העמוד — קובצי PDF נועדו למיקום קבוע, מסמכי Word לטקסט זורם. מי שצריך עותק מדויק 1:1 של הפריסה, לא ימצא זאת ב-PDF → Word בעיקרון, בכל כלי שהוא.
עבור המקרה הנפוץ ביותר — להשתמש בטקסט מ-PDF או לערוך אותו, בלי להקליד אותו מחדש — זה בדרך כלל מספיק לגמרי.
מה מגיע למסמך ה-Word
ההמרה שולפת את הטקסט מה-PDF וכותבת אותו כפסקאות במסמך Word בפורמט A4. הטקסט עצמו עובר במלואו.
מה שלא מגיע, עדיף שנאמר מראש: לא תמונות, לא טבלאות, לא הפריסה. הקובץ שנוצר לא מכיל תיקיית תמונות, לא מבנה טבלה ולא תיבות טקסט. PDF דו-טורי הופך אם כך לחד-טורי, לוגו בכותרת העליונה חסר.
זו החלטה מכוונת, לא מחדל. PDF לא יודע מהי טבלה — הוא יודע רק איפה יש קווים ותווים. שחזור מזה אינו אמין בכל התעשייה, ותוצאה שכמעט נכונה עולה בתיקון יותר זמן מאשר עיצוב הטקסט מחדש בעצמך.
בשביל מה זה מספיק — ובשביל מה לא
לזה זה מספיק היטב: להשתמש בטקסט מ-PDF, לקחת ציטוט, לבנות על חוזה ישן כבסיס לחדש, לשכתב מכתב שהתבנית שלו קיימת רק כ-PDF.
לזה זה לא מספיק: לשחזר מסמך מעוצב בנאמנות ב-Word, להמשיך לערוך חשבונית עם טבלה, לבנות חוברת עם תמונות. מי שצריך את זה, עדיף לו עם המקור אצל השולח.
מקרה מיוחד: ב-PDF סרוקים אין בכלל טקסט לשלוף — העמוד הוא תצלום. שם צריך קודם זיהוי טקסט (OCR), שהופך את התמונה לטקסט; רק אז ההמרה אפשרית.
שאלות נפוצות
הפריסה נשמרת בעת ההמרה? +
לא, בדיוק לא — הטקסט והעיצוב הבסיסי נשמרים, אך לא פריסה מדויקת לפיקסל. זו מגבלה טכנית של PDF → Word באופן כללי, לא רק אצל mousePDF.
האם גם תמונות מה-PDF נשמרות? +
הדגש הוא על טקסט ומבנה. להמשך עיבוד טקסט בלבד זה בדרך כלל מספיק.
אני צריך להירשם כדי לקבל את קובץ ה-Word? +
לא, הקובץ נוצר ומורד ישירות בדפדפן — בלי חשבון, בלי כתובת אימייל.
האם זה עובד גם עם קובצי PDF סרוקים? +
רק אם ה-PDF כבר מכיל טקסט אמיתי — לא אם כל עמוד הוא רק תמונה. במסמכים סרוקים כדאי להריץ קודם את זיהוי הטקסט (OCR), ואז גם המרת ה-Word תעבוד.
האם תמונות מה-PDF נשמרות במסמך ה-Word? +
לא. הקובץ שנוצר מכיל אך ורק טקסט — בדוק מבפנים, אין בו תיקיית תמונות. אם אתה זקוק לתמונות, המרת PDF לתמונות היא הדרך המתאימה.
למה מסמך ה-Word שלי נראה שונה לגמרי מה-PDF? +
כי הטקסט מועבר, לא הפריסה. אתה מקבל פסקאות A4, לא שחזור של העמוד. זה מכוון: תיקון שחזור מקורב אורך יותר זמן מעיצוב הטקסט מחדש.
טבלאות נשמרות כטבלאות? +
לא. תוכן התאים מופיע כטקסט, מבנה הטבלה הולך לאיבוד. PDF לא שומר טבלאות, אלא רק את מיקום הקווים והתווים.
זה עשוי לעזור גם כן
המרת Word ל-PDF
ייצוא מסמך Word כ-PDF, בלי להעלות את הקובץ.
המרת PDF לתמונות
ייצוא כל עמוד PDF כתמונת PNG.
המרת תמונות ל-PDF
המרת תמונות JPG או PNG למסמך PDF.
המרת PDF ל-PowerPoint
העברת כל עמוד PDF כשקופית תמונה למצגת PPTX.
זיהוי טקסט ב-PDF (OCR)
זיהוי טקסט בקובצי PDF סרוקים והפיכתו לניתן לחיפוש.