 mousePDF
Конвертувати PDF у Word — без завантаження, без облікового запису
Експортуйте текст PDF як редагований файл Word (.docx). Конвертація відбувається в браузері, ваш файл нікуди не завантажується.
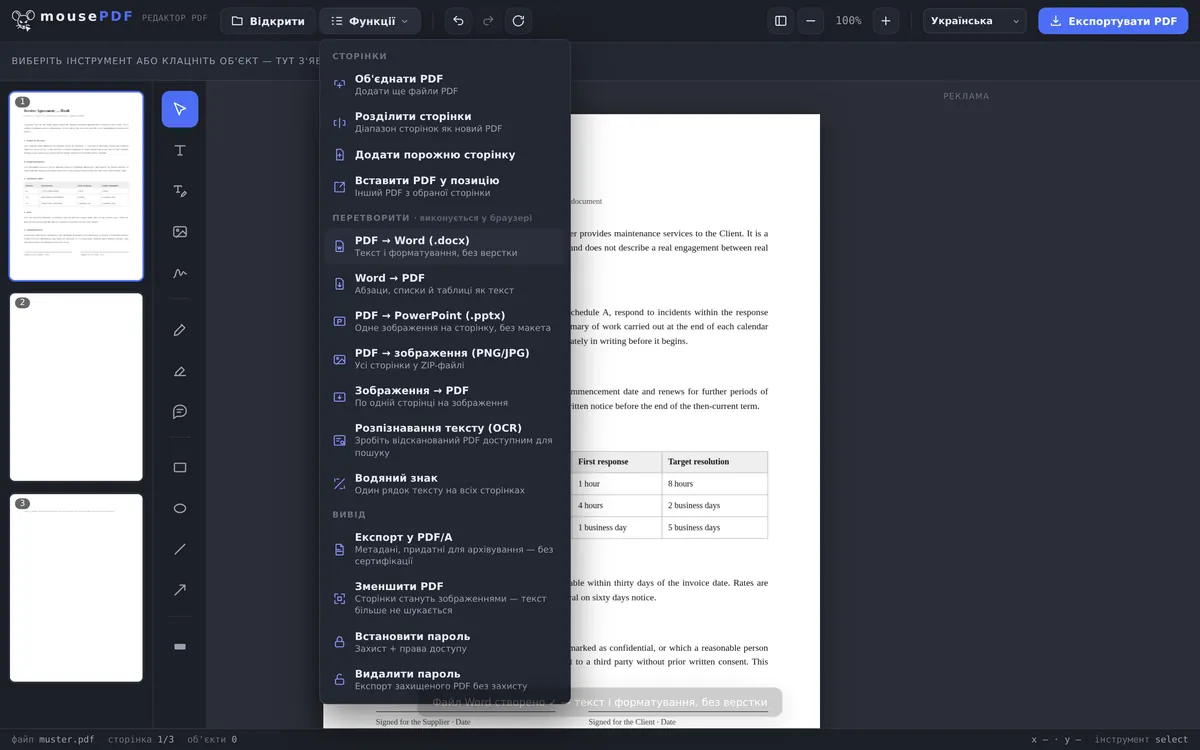
У три кроки
Відкрити PDF
Перетягніть PDF або відкрийте через діалог вибору файлу.
Вибрати «PDF → Word»
У меню «Конвертувати» запустіть конвертацію у Word.
Зберегти файл Word
Завантажити готовий файл .docx безпосередньо.
Що переносить конвертація — а що ні
mousePDF переносить текст і базове форматування (наприклад, абзаци) з PDF у файл Word. Що не переноситься — це точний макет сторінки: PDF створені для фіксованого розташування, документи Word — для плинного тексту. Якщо вам потрібна копія макета 1:1, PDF → Word у принципі не найкращий вибір, незалежно від інструмента.
Для найпоширенішого випадку використання — подальше використання або редагування тексту з PDF без повторного набору — цього зазвичай цілком достатньо.
Що потрапляє в документ Word
Конвертація бере текст з PDF і записує його як абзаци в документ Word формату A4. Сам текст при цьому переноситься повністю.
Що не переноситься, ми краще скажемо заздалегідь: зображення не переносяться, таблиці не переносяться, макет не переноситься. Створений файл не містить папки із зображеннями, структури таблиць чи текстових рамок. Двоколонковий PDF стане одноколонковим, логотип у шапці листа зникне.
Це свідоме рішення, а не недогляд. PDF не знає, що таке таблиця, — він знає лише, де розташовані лінії та символи. Реконструкція з цього в цілому в галузі ненадійна, а результат, який майже правильний, при виправленні коштує більше часу, ніж форматування самого тексту.
Для чого цього достатньо — а для чого ні
Для цього достатньо добре: подальше використання тексту з PDF, перенесення цитати, використання старого договору як основи для нового, переписування листа, шаблон якого існує лише як PDF.
Для цього недостатньо: точне відтворення оформленого документа у Word, редагування рахунку з таблицею, відтворення брошури із зображеннями. Тому, кому це потрібно, краще звернутися по оригінал до відправника.
Особливий випадок: у відсканованих PDF узагалі немає тексту, який можна взяти, — сторінка є фотографією. Тоді спершу потрібне розпізнавання тексту PDF (OCR), яке перетворює зображення на текст; лише після цього конвертація стає можливою.
Часті запитання
Чи зберігається макет під час конвертації? +
Ні, точно не зберігається — переносяться текст і розмітка, але не точний до пікселя макет. Це технічне обмеження PDF → Word загалом, а не лише в mousePDF.
Чи переносяться також зображення з PDF? +
Основна увага приділяється тексту та структурі. Для чистої обробки тексту цього зазвичай достатньо.
Чи потрібно мені реєструватися, щоб отримати файл Word? +
Ні, файл створюється й завантажується прямо в браузері — без облікового запису, без електронної адреси.
Чи працює це також із відсканованими PDF? +
Лише якщо PDF уже містить справжній текст — не якщо кожна сторінка є лише зображенням. Для відсканованих документів спершу варто запустити розпізнавання тексту (OCR), тоді й конвертація у Word спрацює.
Чи зберігаються зображення з PDF у документі Word? +
Ні. Створений файл містить виключно текст — перевірено за його внутрішньою структурою, там немає папки із зображеннями. Якщо вам потрібні зображення, підходящий шлях — конвертувати PDF у зображення.
Чому мій документ Word виглядає зовсім інакше, ніж PDF? +
Тому що переноситься текст, а не макет. Ви отримуєте абзаци формату A4, а не відтворення сторінки. Це навмисно: виправляти приблизне відтворення довше, ніж заново відформатувати текст.
Чи переносяться таблиці як таблиці? +
Ні. Вміст комірок з'являється як текст, структура таблиці втрачається. PDF не зберігає таблиці, а лише розташування ліній і символів.
Це теж може допомогти
Конвертувати Word у PDF
Експортувати документ Word як PDF, не завантажуючи файл.
Конвертувати PDF у зображення
Експортувати кожну сторінку PDF як зображення PNG.
Конвертувати зображення у PDF
Перетворити зображення JPG або PNG на документ PDF.
Конвертувати PDF у PowerPoint
Перенести кожну сторінку PDF як слайд-зображення в презентацію PPTX.
Розпізнавання тексту PDF (OCR)
Розпізнавати текст у відсканованих PDF і робити його придатним для пошуку.