 mousePDF
Pretvaranje PDF-a u Word — bez prijenosa, bez računa
Izvezite PDF-tekst kao uredljivu Word datoteku (.docx). Pretvaranje se odvija u pregledniku, vaša se datoteka nigdje ne prenosi.
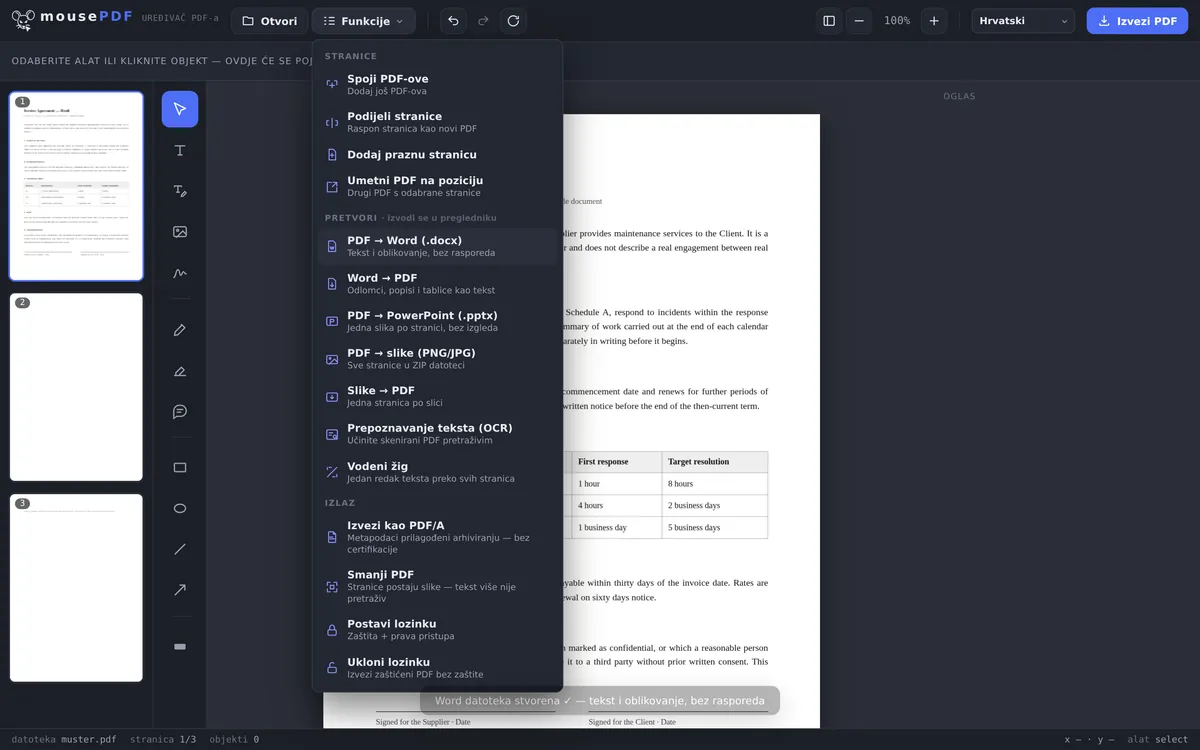
U tri koraka
Otvorite PDF
Ubacite PDF ili ga otvorite putem dijaloškog okvira za datoteke.
Odaberite „PDF → Word”
U izborniku „Pretvori” pokrenite pretvaranje u Word.
Spremite Word datoteku
Preuzmite gotovu .docx datoteku izravno.
Što pretvaranje preuzima — a što ne
mousePDF prenosi tekst i osnovno formatiranje (npr. odlomke) iz PDF-a u Word datoteku. Ono što se ne prenosi je točan izgled stranice — PDF-ovi su namijenjeni fiksnom pozicioniranju, Word dokumenti tekstu u toku. Tko treba 1:1 kopiju izgleda, s pretvaranjem PDF → Word načelno nije dobro poslužen, bez obzira na alat.
Za najčešći slučaj korištenja — daljnje korištenje ili uređivanje teksta iz PDF-a bez ponovnog pretipkavanja — to je u pravilu potpuno dovoljno.
Što stiže u Word dokument
Pretvaranje dohvaća tekst iz PDF-a i piše ga kao odlomke u Word dokument u A4 formatu. Sam tekst pritom se prenosi u potpunosti.
Što ne stiže, radije kažemo unaprijed: slike ne, tablice ne, izgled ne. Generirana datoteka ne sadrži mapu sa slikama, strukturu tablica niti tekstualne okvire. Dvostupčani PDF postaje jednostupčani, logo u zaglavlju nedostaje.
To je namjerna odluka, a ne propust. PDF ne zna što je tablica — zna samo gdje se nalaze crte i znakovi. Rekonstrukcija iz toga nepouzdana je diljem branše, a rezultat koji je skoro ispravan pri popravljanju košta više vremena nego samo oblikovanje teksta.
Za što je dovoljno — a za što nije
Za ovo je dobro dovoljno: daljnje korištenje teksta iz PDF-a, preuzimanje citata, uzimanje starog ugovora kao osnove za novi, prepisivanje pisma čiji predložak postoji samo kao PDF.
Za ovo nije dovoljno: vjerno rekonstruirati dizajnirani dokument u Wordu, dalje obrađivati račun s tablicom, izraditi brošuru sa slikama. Tko to treba, bolje je poslužen originalom kod pošiljatelja.
Poseban slučaj: kod skeniranih PDF-ova uopće nema teksta koji bi se mogao dohvatiti — stranica je fotografija. Tamo prvo mora proći prepoznavanje teksta PDF-a (OCR), koje od slike stvara tekst; tek nakon toga je pretvaranje moguće.
Često postavljana pitanja
Ostaje li izgled sačuvan pri pretvaranju? +
Ne, točno ne — prenose se tekst i oznake, ali ne piksel-precizan izgled. To je tehnička granica PDF → Word općenito, ne samo kod mousePDF-a.
Prenose li se i slike iz PDF-a? +
Fokus je na tekstu i strukturi. Za čisto daljnje korištenje teksta to je najčešće dovoljno.
Moram li se prijaviti da bih dobio Word datoteku? +
Ne, datoteka se izravno generira i preuzima u pregledniku — bez računa, bez e-adrese.
Radi li to i kod skeniranih PDF-ova? +
Samo ako PDF već sadrži pravi tekst — ne ako je svaka stranica samo slika. Kod skeniranih dokumenata prethodno pokrenite prepoznavanje teksta (OCR), tada uspijeva i pretvaranje u Word.
Ostaju li slike iz PDF-a sačuvane u Word dokumentu? +
Ne. Generirana datoteka sadrži isključivo tekst — provjereno u njezinoj unutrašnjosti, u njoj nema mape sa slikama. Ako trebate slike, pretvaranje PDF-a u slike je pravi put.
Zašto moj Word dokument izgleda potpuno drugačije od PDF-a? +
Jer se prenosi tekst, ne izgled. Dobivate A4 odlomke, ne repliku stranice. To je namjerno: popravljanje približne replike traje dulje nego ponovno oblikovanje teksta.
Prenose li se tablice kao tablice? +
Ne. Sadržaj ćelija pojavljuje se kao tekst, struktura tablice se gubi. PDF ne pohranjuje tablice, već samo položaj crta i znakova.
Ovo bi vam također moglo pomoći
Pretvaranje Worda u PDF
Izvezite Word dokument kao PDF, bez prijenosa datoteke.
Pretvaranje PDF-a u slike
Izvezite svaku stranicu PDF-a kao PNG sliku.
Pretvaranje slika u PDF
Pretvorite JPG ili PNG slike u PDF dokument.
Pretvaranje PDF-a u PowerPoint
Prenesite svaku PDF-stranicu kao sliku-slajd u PPTX prezentaciju.
Prepoznavanje teksta u PDF-u (OCR)
Prepoznajte tekst u skeniranim PDF-ovima i učinite ga pretraživim.