 mousePDF
זיהוי טקסט ב-PDF (OCR) — ללא העלאה
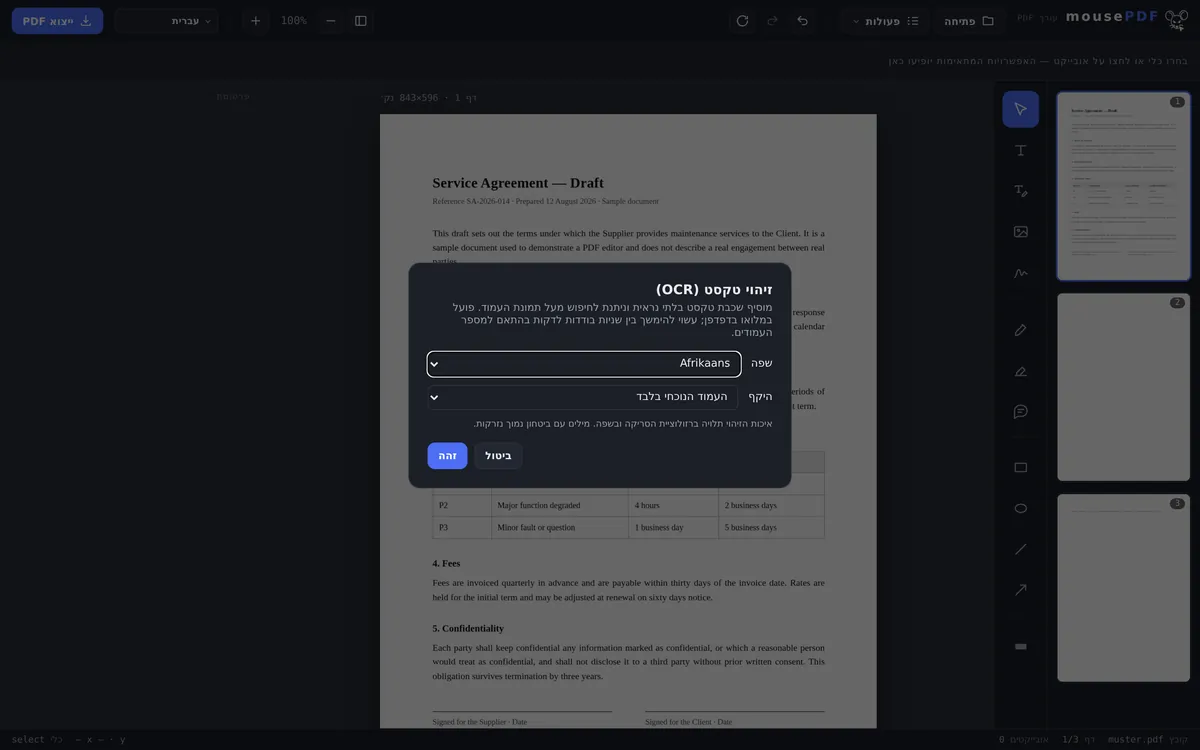
הנח שכבת טקסט בלתי נראית וניתנת לחיפוש מעל עמודי PDF סרוקים או קיימים כתמונה. הזיהוי מתבצע לגמרי בדפדפן שלך, הקובץ שלך לעולם לא מועלה.
בשלושה שלבים
פתיחת PDF
גרור PDF סרוק או מבוסס-תמונה לחלון או בחר אותו.
בחירת שפה והיקף
קבע את שפת הזיהוי והחלט אם לזהות רק את העמוד הנוכחי או את כל המסמך.
ייצוא
שמור PDF עם שכבת טקסט ניתנת לחיפוש ובלתי נראית — תמונת העמוד נשארת ללא שינוי חזותי.
מקרה טיפוסי: הפיכת מסמכים סרוקים לניתנים לחיפוש
חוזים, חשבוניות או ספרים סרוקים מכילים לרוב רק תמונת עמוד, לא טקסט אמיתי — אי אפשר לחפש בהם או להעתיק מהם טקסט. mousePDF מזהה את הטקסט מקומית בדפדפן ומניח אותו בצורה בלתי נראית מעל התמונה, כך שחיפוש והעתקה עובדים, בלי שמראה העמוד משתנה.
זיהוי טקסט בדפדפן — ומה מיוחד בזה
OCR שייך למשימות שבדרך כלל כמעט בהכרח מעלים בשבילן משהו: הזיהוי דורש מודל שפה, וזה בדרך כלל יושב על שרת. כאן הוא פועל בדפדפן שלך; רק המודל נטען, לעולם לא הקובץ שלך.
זה חשוב במיוחד במסמכים שסורקים בדרך כלל: חוזים, תלושי משכורת, מכתבי רופאים, צילומי תעודת זהות. סריקה היא תמונה — ולפני שהיא הופכת לניתנת לחיפוש, משהו צריך לקרוא אותה. שהדבר הזה פועל על המכשיר שלך בדפדפן שלך, זה ההבדל האמיתי.
28 שפות עומדות לרשות ה-OCR. המודל של השפה הנבחרת נטען רק בעת הריצה בפועל — כך העמוד נשאר קליל, ואתה טוען רק את מה שאתה צריך.
היכן הזיהוי מגיע לגבולותיו
כתבים שאינם לטיניים חסרים במכוון. אין קירילית, אין סינית, יפנית או קוריאנית, אין ערבית, עברית, דוונגרי או תאית. המודלים בשבילם גדולים משמעותית ואחוז ההצלחה נמוך בהרבה — תוצאה שצריך לתקן תו-תו לא עוזרת לאף אחד. יוונית נכללת, כי היא לא נופלת לאותה קטגוריה בהיבט הזה.
הזיהוי אף פעם לא חף משגיאות. הוא קורא בחזרה מפיקסלים מה שהיה פעם טקסט. סריקה נקייה ומיושרת נותנת תוצאות טובות מאוד; תצלום נייד עקום בתאורה גרועה, כתב יד עקוב או גופן קישוטי חריג נותנים תוצאות גרועות משמעותית. מי שממשיך להשתמש בטקסט צריך לבדוק אותו — זה נכון לכל גרסה שעברה OCR, לא רק לזו.
מראה העמוד לא משתנה. הטקסט המזוהה מונח כשכבה בלתי נראית מעל התמונה: אתה עדיין רואה את הסריקה שלך, אך יכול לחפש ולסמן בה. שגיאות זיהוי לכן לא נראות בתמונה — הן מתגלות רק כשאתה מעתיק טקסט.
ה-OCR שימושי גם אחרי כיווץ PDF: אז העמודים הופכים לתמונות ומאבדים את שכבת הטקסט שלהם — זיהוי הטקסט יוצר אותה מחדש.
שאלות נפוצות
האם המסמך שלי מועלה לצורך זיהוי הטקסט? +
לא. הזיהוי מתבצע לגמרי בדפדפן דרך מנוע OCR שנטען מקומית — הקובץ לעולם לא עוזב את המכשיר שלך.
אילו שפות נתמכות? +
מבחר רחב של שפות אירופיות בכתב לטיני או יווני. כתבים כמו סינית, ערבית, קירילית או דוונגרי אינם נתמכים כרגע ב-OCR.
כמה זמן לוקח הזיהוי? +
בהתאם למספר העמודים וביצועי המכשיר, בין כמה שניות לכמה דקות.
זיהוי הטקסט משנה את מראה העמוד? +
לא. תמונת העמוד נשארת זהה בדיוק, שכבת הטקסט המזוהה יושבת בלתי נראית מעליה — רק חיפוש והעתקה הופכים אפשריים בזכות זה.
כמה טוב הזיהוי במסמכים סרוקים גרוע או בכתב יד? +
הזיהוי עובד הכי טוב עם טקסטים מודפסים בצורה נקייה וקריאה. בהערות בכתב יד או בסריקות עם רעש רב, הדיוק יורד — אז תווים בודדים עלולים להיות מזוהים לא נכון או חסרים.
אילו שפות מזוהות? +
28, כולן בכתב לטיני בתוספת יוונית. כתבים שאינם לטיניים כמו קירילית, סינית, ערבית, עברית או תאית אינם נכללים במכוון — אחוז ההצלחה שם היה נמוך משמעותית.
כמה מדויק הזיהוי? +
בסריקה נקייה וישרה — טוב מאוד; בתצלומי נייד עקומים, תאורה גרועה או כתב יד — גרוע בהרבה. מי שממשיך להשתמש בטקסט צריך לבדוק אותו.
המסמך שלי נראה אחרת אחרי זיהוי הטקסט? +
לא. הטקסט המזוהה מגיע כשכבה בלתי נראית מעל התמונה — העמוד נראה כמו קודם, אך ניתן לחיפוש.
זה עשוי לעזור גם כן
כיווץ PDF
הקטנת קובצי PDF עתירי תמונות באופן ניכר — העמודים הופכים לתמונות.
המרת PDF ל-PDF/A
המרה לפורמט PDF/A הידידותי לארכיון — לרשויות ולאחסון לטווח ארוך.
המרת PDF ל-Word
ייצוא טקסט PDF כקובץ Word הניתן לעריכה — בלי העלאה.
עריכת טקסט ב-PDF
לחיצה על טקסט קיים ב-PDF והחלפתו בטקסט חדש.