 mousePDF
Розпізнавання тексту PDF (OCR) — без завантаження
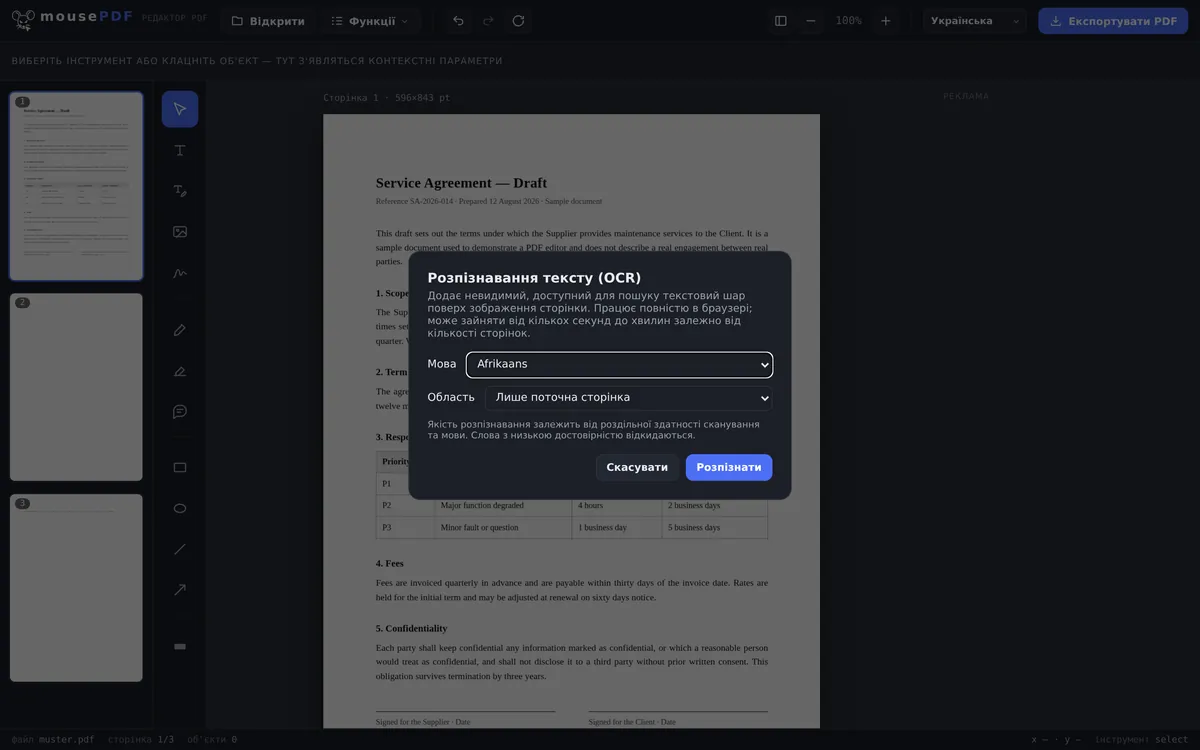
Накладіть невидимий, придатний для пошуку текстовий шар на відскановані сторінки PDF або сторінки у вигляді зображення. Розпізнавання відбувається повністю у вашому браузері, ваш файл ніколи не завантажується.
У три кроки
Відкрити PDF
Перетягніть відсканований PDF або PDF на основі зображення у вікно чи виберіть його.
Вибрати мову й обсяг
Визначте мову розпізнавання і вирішіть, чи потрібно розпізнати лише поточну сторінку, чи весь документ.
Експортувати
Зберегти PDF із придатним для пошуку невидимим текстовим шаром — зображення сторінки візуально залишається незмінним.
Типовий випадок: зробити відскановані документи придатними для пошуку
Відскановані договори, рахунки чи книги часто містять лише зображення сторінки, без справжнього тексту — у них не можна ні шукати, ні копіювати текст. mousePDF розпізнає текст локально в браузері й накладає його невидимо поверх зображення, тож пошук і копіювання починають працювати, а зовнішній вигляд сторінки при цьому не змінюється.
Розпізнавання тексту в браузері — і чим воно особливе
OCR належить до завдань, для яких зазвичай майже неминуче доводиться щось завантажувати: розпізнаванню потрібна мовна модель, а вона зазвичай розташована на сервері. Тут воно працює у вашому браузері; завантажується лише модель, ніколи ваш файл.
Це особливо важливо саме для документів, які сканують: договорів, розрахункових листків, медичних довідок, копій документів. Скан — це зображення, і перш ніж воно стане придатним для пошуку, щось має його прочитати. Те, що це «щось» працює на вашому власному пристрої у вашому браузері, і є справжньою відмінністю.
Для OCR доступно 28 мов. Модель обраної мови довантажується лише під час фактичного запуску — завдяки цьому сторінка залишається легкою, і ви завантажуєте лише те, що вам потрібно.
Де розпізнавання досягає своїх меж
Нелатинські шрифти свідомо відсутні. Немає кирилиці, немає китайської, японської чи корейської, немає арабської, івриту, деванагарі чи тайської. Моделі для них значно більші, а точність розпізнавання помітно нижча — результат, який потрібно виправляти по символу, нікому не допомагає. Грецька мова присутня, оскільки в цьому відношенні не потрапляє в той самий клас.
Розпізнавання ніколи не буває бездоганним. Воно зчитує з пікселів те, що колись було текстом. Чіткий скан із рівним вирівнюванням дає дуже добрі результати; кривувате фото з телефону при поганому освітленні, нерозбірливий почерк або незвичайний декоративний шрифт — помітно гірші. Хто використовує текст далі, повинен його перевірити — це стосується будь-якої версії, обробленої OCR, а не лише цієї.
Зовнішній вигляд сторінки не змінюється. Розпізнаний текст накладається як невидимий шар поверх зображення: ви й далі бачите свій скан, але тепер можете в ньому шукати й виділяти текст. Тому помилки розпізнавання не видно на зображенні — вони проявляються лише тоді, коли ви копіюєте текст.
OCR також корисне після стиснення PDF: при цьому сторінки перетворюються на зображення й втрачають свій текстовий шар — розпізнавання тексту створює його заново.
Часті запитання
Чи завантажується мій документ для розпізнавання тексту? +
Ні. Розпізнавання повністю відбувається в браузері за допомогою локально завантаженого механізму OCR — файл ніколи не залишає ваш пристрій.
Які мови підтримуються? +
Великий вибір європейських мов із латинською або грецькою писемністю. Такі писемності, як китайська, арабська, кирилиця чи деванагарі, наразі не підтримуються для OCR.
Скільки триває розпізнавання? +
Залежно від кількості сторінок і продуктивності пристрою — від кількох секунд до кількох хвилин.
Чи змінює розпізнавання тексту зовнішній вигляд сторінки? +
Ні. Зображення сторінки залишається абсолютно незмінним, розпізнаний текстовий шар лежить невидимо поверх нього — це уможливлює лише пошук і копіювання.
Наскільки добре працює розпізнавання на погано відсканованих або рукописних документах? +
Розпізнавання працює найкраще з чисто надрукованим, добре читабельним текстом. У рукописних нотатках або сильно зашумлених сканах точність знижується — тоді окремі символи можуть розпізнаватися неправильно або пропускатися.
Які мови розпізнаються? +
28, усі з латинською писемністю плюс грецька. Нелатинські писемності, такі як кирилиця, китайська, арабська, іврит чи тайська, свідомо відсутні — точність там була б значно нижчою.
Наскільки точне розпізнавання? +
На чистому, рівному скані — дуже добре; на кривуватих фото з телефону, при поганому освітленні чи почерку — помітно гірше. Хто використовує текст далі, повинен його перевірити.
Чи виглядає мій документ інакше після розпізнавання тексту? +
Ні. Розпізнаний текст додається як невидимий шар поверх зображення — сторінка виглядає так само, як раніше, але тепер придатна для пошуку.
Це теж може допомогти
Стиснути PDF
Значно зменшити PDF, насичений зображеннями — сторінки при цьому стають зображеннями.
Конвертувати PDF у PDF/A
Конвертувати у придатний для архівування формат PDF/A — для органів влади й довготривалого зберігання.
Конвертувати PDF у Word
Експортувати текст PDF як редагований файл Word — без завантаження.
Редагувати текст PDF
Клацнути наявний текст у PDF і замінити його новим.