 mousePDF
Prepoznavanje teksta PDF-a (OCR) — bez prijenosa
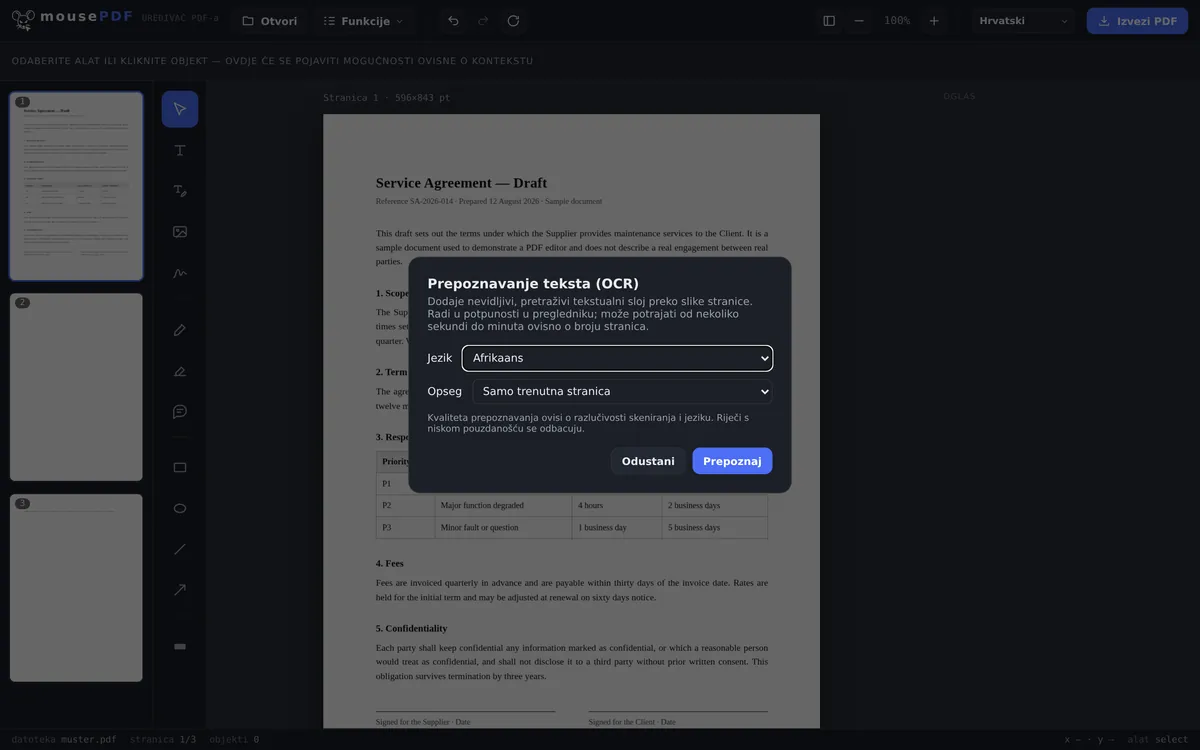
Postavite nevidljivi, pretraživi tekstualni sloj preko skeniranih ili kao slika prisutnih PDF-stranica. Prepoznavanje se u potpunosti odvija u vašem pregledniku, vaša se datoteka nikad ne prenosi.
U tri koraka
Otvorite PDF
Povucite skenirani ili na slici temeljeni PDF u prozor ili ga odaberite.
Odaberite jezik i opseg
Odredite jezik prepoznavanja i odlučite treba li se prepoznati samo trenutna stranica ili cijeli dokument.
Izvezite
Spremite PDF s pretraživim, nevidljivim tekstualnim slojem — slika stranice ostaje vizualno nepromijenjena.
Tipičan slučaj: učiniti skenirane dokumente pretraživima
Skenirani ugovori, računi ili knjige često sadrže samo sliku stranice, ne pravi tekst — u njima se ne može ni pretraživati ni kopirati tekst. mousePDF prepoznaje tekst lokalno u pregledniku i postavlja ga nevidljivo preko slike, tako da pretraživanje i kopiranje funkcioniraju, a da se pritom ništa ne mijenja u izgledu stranice.
Prepoznavanje teksta u pregledniku — i po čemu je posebno
OCR spada u zadatke za koje se inače gotovo nužno nešto prenosi: prepoznavanje treba jezični model, a on se obično nalazi na poslužitelju. Ovdje se odvija u vašem pregledniku; učitava se samo model, nikad vaša datoteka.
To je posebno važno kod dokumenata koje se skenira: ugovori, platne liste, liječnička pisma, kopije osobnih dokumenata. Sken je slika — a prije nego što postane pretraživ, nešto ga mora pročitati. Da se to nešto odvija na vašem vlastitom uređaju u vašem pregledniku, to je prava razlika.
28 jezika je dostupno za OCR. Model odabranog jezika učitava se tek pri stvarnom pokretanju — stranica time ostaje lagana, a preuzimate samo ono što trebate.
Gdje prepoznavanje dolazi do svojih granica
Nelatinična pisma namjerno nedostaju. Nema ćirilice, nema kineskog, japanskog ili korejskog, nema arapskog, hebrejskog, devanagarija ili tajlandskog. Modeli za to znatno su veći, a stopa točnosti primjetno niža — rezultat koji treba ispravljati znak po znak, nikome ne pomaže. Grčki je uključen jer u tom pogledu ne spada u istu klasu.
Prepoznavanje nikad nije bez pogrešaka. Ono iz piksela iščitava ono što je nekoć bilo tekst. Čist sken s ravnom orijentacijom daje vrlo dobre rezultate; iskrivljena fotografija mobitelom pri lošem svjetlu, nečitak rukopis ili neobičan ukrasni font znatno lošije. Tko dalje koristi tekst, trebao bi ga provjeriti — to vrijedi za svaku OCR obrađenu verziju, ne samo za ovu.
Izgled stranice se ne mijenja. Prepoznati tekst postavlja se kao nevidljivi sloj preko slike: i dalje vidite svoj sken, ali u njemu možete pretraživati i označavati. Greške u prepoznavanju stoga nisu vidljive na slici — pokazuju se tek kad kopirate tekst.
OCR je koristan i nakon sažimanja PDF-a: stranice pritom postaju slike i gube svoj tekstualni sloj — prepoznavanje teksta ga ponovno postavlja.
Često postavljana pitanja
Prenosi li se moj dokument za prepoznavanje teksta? +
Ne. Prepoznavanje se u potpunosti odvija u pregledniku putem lokalno učitanog OCR alata — datoteka nikad ne napušta vaš uređaj.
Koji jezici su podržani? +
Veći izbor europskih jezika s latiničnim ili grčkim pismom. Pisma poput kineskog, arapskog, ćiriličnog ili devanagarija trenutno nisu podržana za OCR.
Koliko traje prepoznavanje? +
Ovisno o broju stranica i performansama uređaja, nekoliko sekundi do nekoliko minuta.
Mijenja li prepoznavanje teksta izgled stranice? +
Ne. Slika stranice ostaje potpuno ista, prepoznati tekstualni sloj leži nevidljivo preko nje — time postaju moguća samo pretraživanje i kopiranje.
Koliko je dobro prepoznavanje kod loše skeniranih ili rukom pisanih dokumenata? +
Prepoznavanje najbolje funkcionira kod čisto tiskanih, dobro čitljivih tekstova. Kod rukom pisanih bilježaka ili jako zašumljenih skenova točnost opada — tada pojedini znakovi mogu biti pogrešno prepoznati ili nedostajati.
Koji se jezici prepoznaju? +
28, svi s latiničnim pismom plus grčki. Nelatinična pisma poput ćirilice, kineskog, arapskog, hebrejskog ili tajlandskog namjerno nisu uključena — stopa točnosti tamo bi bila znatno lošija.
Koliko je precizno prepoznavanje? +
Kod čistog, ravnog skena vrlo dobro; kod iskrivljenih fotografija mobitelom, lošeg svjetla ili rukopisa primjetno lošije. Tko dalje koristi tekst, trebao bi ga provjeriti.
Izgleda li moj dokument drugačije nakon prepoznavanja teksta? +
Ne. Prepoznati tekst dolazi kao nevidljivi sloj preko slike — stranica izgleda isto kao prije, ali je pretraživa.
Ovo bi vam također moglo pomoći
Sažimanje PDF-a
Znatno smanjite PDF-ove bogate slikama — stranice pritom postaju slike.
Pretvaranje PDF-a u PDF/A
Pretvorite u arhivski format PDF/A — za javne ustanove i dugoročnu pohranu.
Pretvaranje PDF-a u Word
Izvezite PDF-tekst kao uredljivu Word datoteku — bez prijenosa.
Uređivanje PDF-teksta
Kliknite postojeći tekst u PDF-u i zamijenite ga novim.