 mousePDF
Reconnaissance de texte PDF (OCR) sans transfert
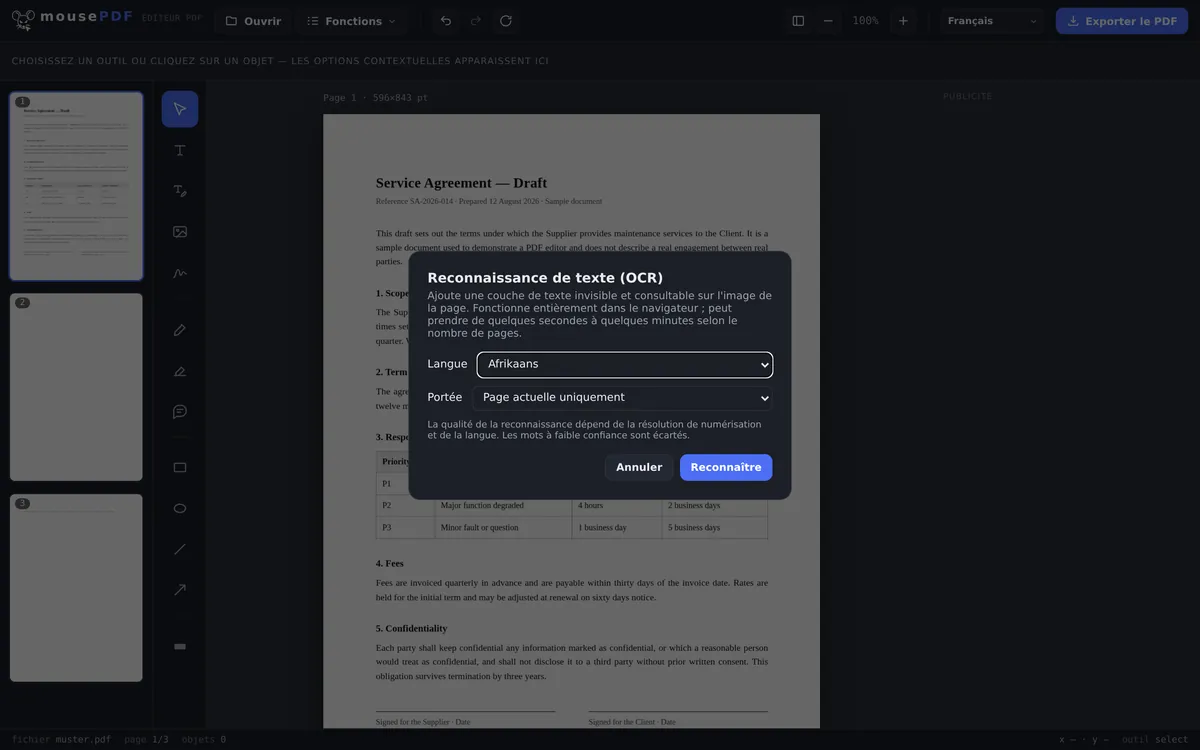
Ajoutez une couche de texte invisible et consultable sur des pages PDF scannées ou en image. La reconnaissance se fait entièrement dans votre navigateur, votre fichier n'est jamais transféré.
En trois étapes
Ouvrir le PDF
Glissez un PDF scanné ou en image dans la fenêtre, ou sélectionnez-le.
Choisir la langue et la portée
Définissez la langue de reconnaissance et choisissez si seule la page actuelle ou tout le document doit être traité.
Exporter
Enregistrez le PDF avec une couche de texte consultable et invisible. L'image de la page reste visuellement inchangée.
Rendre des documents numérisés consultables
Les contrats, factures ou livres scannés ne contiennent souvent qu'une image de page, pas de vrai texte, impossible d'y faire une recherche ou de copier du texte. mousePDF reconnaît le texte localement dans le navigateur et le place, invisible, sur l'image, pour que la recherche et la copie fonctionnent sans rien changer à l'apparence de la page.
Pourquoi une reconnaissance sur votre propre appareil est inhabituelle
L'OCR fait partie des tâches pour lesquelles on transfère presque toujours quelque chose : la reconnaissance a besoin d'un modèle linguistique, qui se trouve habituellement sur un serveur. Ici, elle tourne dans votre navigateur ; seul le modèle est chargé, jamais votre fichier.
C'est justement important pour les documents qu'on scanne : contrats, fiches de paie, courriers médicaux, copies de pièces d'identité. Un scan est une image, et avant de devenir consultable, il faut que quelque chose la lise. Que ce quelque chose tourne sur votre propre appareil, dans votre navigateur, c'est là toute la différence.
28 langues sont disponibles pour l'OCR. Le modèle de la langue choisie n'est chargé qu'au moment de l'exécution réelle. La page reste ainsi légère, et vous ne chargez que ce dont vous avez besoin.
Où la reconnaissance atteint ses limites
Les écritures non latines manquent délibérément. Pas de cyrillique, pas de chinois, japonais ou coréen, pas d'arabe, hébreu, devanagari ou thaï. Les modèles pour ces écritures sont nettement plus volumineux et le taux de réussite sensiblement plus faible, un résultat qu'il faut corriger caractère par caractère n'aide personne. Le grec est inclus, car il n'entre pas dans la même catégorie à cet égard.
La reconnaissance n'est jamais parfaite. Elle relit à partir de pixels ce qui était autrefois du texte. Un scan propre et bien droit donne d'excellents résultats ; une photo de téléphone de travers dans une lumière médiocre, une écriture manuscrite hésitante ou une police décorative inhabituelle, nettement moins bons. Qui réutilise le texte devrait le relire, cela vaut pour toute version traitée par OCR, pas seulement celle-ci.
L'apparence de la page ne change pas. Le texte reconnu est posé comme une couche invisible sur l'image : vous continuez à voir votre scan, mais vous pouvez y faire une recherche et le sélectionner. Les erreurs de reconnaissance ne sont donc pas visibles dans l'image. Elles n'apparaissent que si vous copiez le texte.
L'OCR est aussi utile après avoir compressé un PDF : les pages deviennent alors des images et perdent leur couche de texte, la reconnaissance de texte la recrée.
Questions fréquentes
Mon document est-il transféré pour la reconnaissance de texte ? +
Non. La reconnaissance se fait entièrement dans le navigateur grâce à un moteur OCR chargé localement, le fichier ne quitte jamais votre appareil.
Quelles langues sont prises en charge ? +
Un large choix de langues européennes en écriture latine ou grecque. Les écritures comme le chinois, l'arabe, le cyrillique ou le devanagari ne sont actuellement pas prises en charge pour l'OCR.
Combien de temps dure la reconnaissance ? +
Selon le nombre de pages et la puissance de l'appareil, de quelques secondes à quelques minutes.
La reconnaissance de texte modifie-t-elle l'apparence de la page ? +
Non. L'image de la page reste exactement identique, la couche de texte reconnue est invisible par-dessus, seules la recherche et la copie deviennent ainsi possibles.
Quelle est la qualité de la reconnaissance pour des documents mal scannés ou manuscrits ? +
La reconnaissance fonctionne le mieux avec des textes imprimés proprement et bien lisibles. Pour des notes manuscrites ou des scans très bruités, la précision diminue; certains caractères peuvent alors être mal reconnus ou manquants.
Quelles langues sont reconnues ? +
28, toutes en écriture latine plus le grec. Les écritures non latines comme le cyrillique, le chinois, l'arabe, l'hébreu ou le thaï sont volontairement absentes, le taux de réussite y serait nettement inférieur.
Quelle est la précision de la reconnaissance ? +
Très bonne sur un scan propre et bien droit ; nettement moins bonne sur une photo de téléphone de travers, une lumière médiocre ou de l'écriture manuscrite. Qui réutilise le texte devrait le relire.
Mon document a-t-il une apparence différente après la reconnaissance de texte ? +
Non. Le texte reconnu arrive comme une couche invisible sur l'image, la page a la même apparence qu'avant, mais elle est désormais consultable.
Cela pourrait aussi vous aider
Compresser un PDF
Réduisez nettement la taille des PDF riches en images, les pages deviennent alors des images.
Convertir PDF en PDF/A
Convertissez-le au format PDF/A adapté à l'archivage, pour les administrations et la conservation à long terme.
Convertir PDF en Word
Exportez le texte d'un PDF en fichier Word modifiable, sans transfert.
Modifier le texte d'un PDF
Cliquez sur le texte existant du PDF et remplacez-le par du nouveau texte.