 mousePDF
Reconhecimento de texto em PDF (OCR) — sem envio
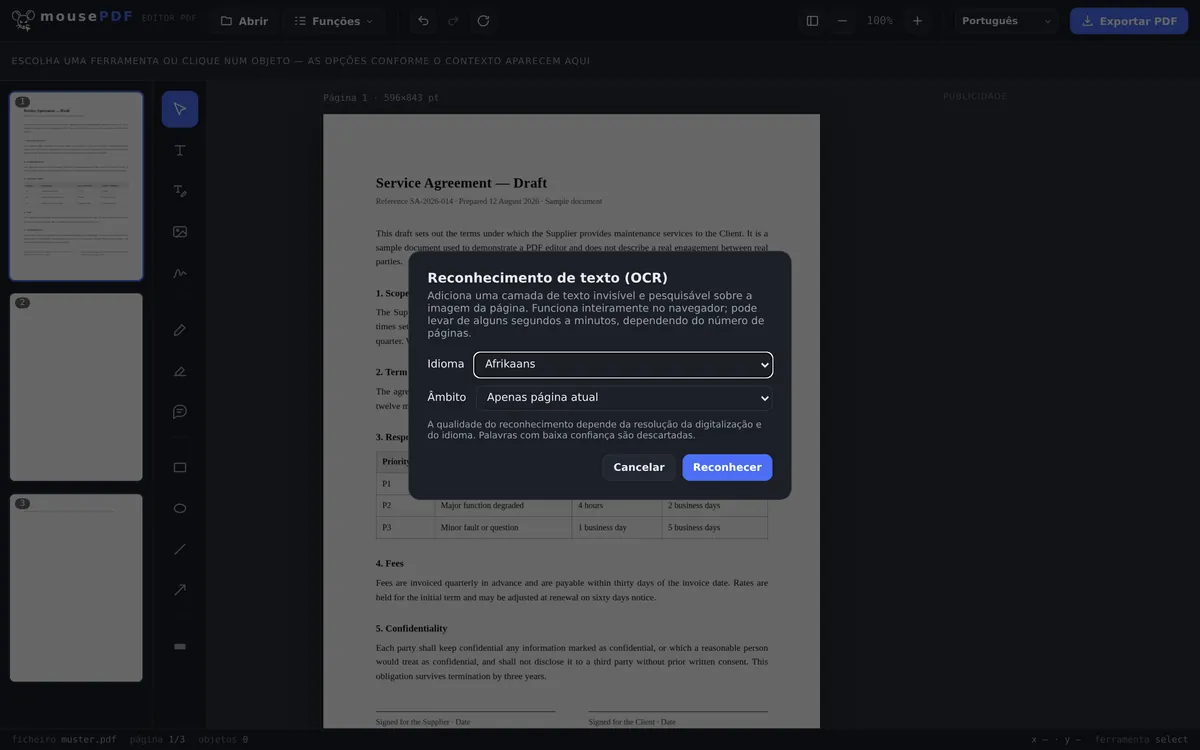
Coloca uma camada de texto invisível e pesquisável sobre páginas de PDF digitalizadas ou em formato de imagem. O reconhecimento acontece totalmente no teu navegador, o teu ficheiro nunca é enviado.
Em três passos
Abrir o PDF
Arrasta para a janela um PDF digitalizado ou baseado em imagem, ou seleciona-o.
Escolher idioma e âmbito
Define o idioma de reconhecimento e decide se é processada só a página atual ou o documento inteiro.
Exportar
Guarda o PDF com uma camada de texto invisível e pesquisável — a imagem da página não muda visualmente.
Caso típico: tornar pesquisáveis documentos digitalizados
Contratos, faturas ou livros digitalizados costumam conter apenas a imagem da página, sem texto real — não é possível pesquisar nem copiar texto neles. O mousePDF reconhece o texto localmente no navegador e coloca-o de forma invisível sobre a imagem, de modo que a pesquisa e a cópia funcionam sem que o aspeto da página mude.
Reconhecimento de texto no navegador — e o que tem de especial
O OCR é uma daquelas tarefas para as quais normalmente é quase inevitável enviar algo: o reconhecimento precisa de um modelo de idioma, que costuma estar alojado num servidor. Aqui é executado no teu navegador; só é descarregado o modelo, nunca o teu ficheiro.
Isto é precisamente importante nos documentos que se digitalizam: contratos, recibos de vencimento, relatórios médicos, cópias do cartão de cidadão. Uma digitalização é uma imagem — e antes de ser pesquisável, algo tem de a ler. Que esse algo seja executado no teu próprio dispositivo, no teu navegador, é a verdadeira diferença.
Há 28 idiomas disponíveis para OCR. O modelo do idioma escolhido só é descarregado na execução efetiva — a página mantém-se assim leve, e só descarregas o que precisas.
Onde o reconhecimento chega aos seus limites
As escritas não latinas faltam propositadamente. Nada de cirílico, nem chinês, japonês ou coreano, nem árabe, hebraico, devanágari ou tailandês. Os modelos para essas escritas são consideravelmente maiores e a taxa de acerto claramente mais baixa — um resultado que é preciso corrigir carácter a carácter não ajuda ninguém. O grego está incluído, porque nesse aspeto não fica na mesma categoria.
O reconhecimento nunca é isento de erros. Reconstrói a partir de pixels o que outrora foi texto. Uma digitalização limpa e bem alinhada dá muito bons resultados; uma fotografia de telemóvel torta com má luz, uma caligrafia rabiscada ou um tipo de letra decorativo pouco habitual dão resultados claramente piores. Quem reaproveitar o texto deve revê-lo — isto vale para qualquer OCR, não só para este.
O aspeto da página não muda. O texto reconhecido é colocado como uma camada invisível sobre a imagem: continuas a ver a tua digitalização, mas passas a poder pesquisar e selecionar nela. Por isso, os erros de reconhecimento não são visíveis na imagem — só aparecem quando copias o texto.
O OCR também é útil depois de comprimir um PDF: nesse processo as páginas tornam-se imagens e perdem a sua camada de texto — o reconhecimento de texto volta a criá-la.
Perguntas frequentes
O meu documento é enviado para o reconhecimento de texto? +
Não. O reconhecimento acontece totalmente no navegador através de um motor de OCR carregado localmente — o ficheiro nunca sai do teu dispositivo.
Que idiomas são suportados? +
Uma ampla seleção de idiomas europeus com escrita latina ou grega. Escritas como o chinês, o árabe, o cirílico ou o devanágari não são atualmente suportadas para OCR.
Quanto tempo demora o reconhecimento? +
Consoante o número de páginas e a capacidade do dispositivo, de alguns segundos a poucos minutos.
O reconhecimento de texto altera o aspeto da página? +
Não. A imagem da página mantém-se exatamente igual, a camada de texto reconhecida fica invisível por cima — só a pesquisa e a cópia passam a ser possíveis.
Qual é a qualidade do reconhecimento em documentos mal digitalizados ou manuscritos? +
O reconhecimento funciona melhor com textos impressos limpos e bem legíveis. Em notas manuscritas ou digitalizações muito ruidosas, a precisão desce — podem ser reconhecidos incorretamente ou faltar caracteres isolados.
Que idiomas são reconhecidos? +
28, todos com escrita latina mais o grego. Escritas não latinas como o cirílico, o chinês, o árabe, o hebraico ou o tailandês foram deliberadamente deixadas de fora — aí a taxa de acerto seria claramente pior.
Qual é a precisão do reconhecimento? +
Muito boa com uma digitalização limpa e direita; visivelmente pior com fotografias de telemóvel tortas, má luz ou caligrafia manuscrita. Quem reaproveitar o texto deve revê-lo.
O meu documento fica com um aspeto diferente depois do reconhecimento de texto? +
Não. O texto reconhecido é acrescentado como uma camada invisível sobre a imagem — a página tem o mesmo aspeto de antes, mas passa a ser pesquisável.
Isto também pode ajudar
Comprimir PDF
Reduz significativamente PDF com muitas imagens — as páginas são convertidas em imagens.
Converter PDF em PDF/A
Converte para o formato PDF/A, próprio para arquivo — para organismos públicos e armazenamento a longo prazo.
Converter PDF em Word
Exporta o texto do PDF como um ficheiro Word editável — sem envio.
Editar texto do PDF
Clica no texto existente do PDF e substitui-o por um novo.