 mousePDF
Распознавание текста PDF (OCR) — без загрузки
Наложи невидимый, доступный для поиска текстовый слой на отсканированные или представленные в виде изображения страницы PDF. Распознавание происходит полностью в твоём браузере, твой файл никогда не загружается.
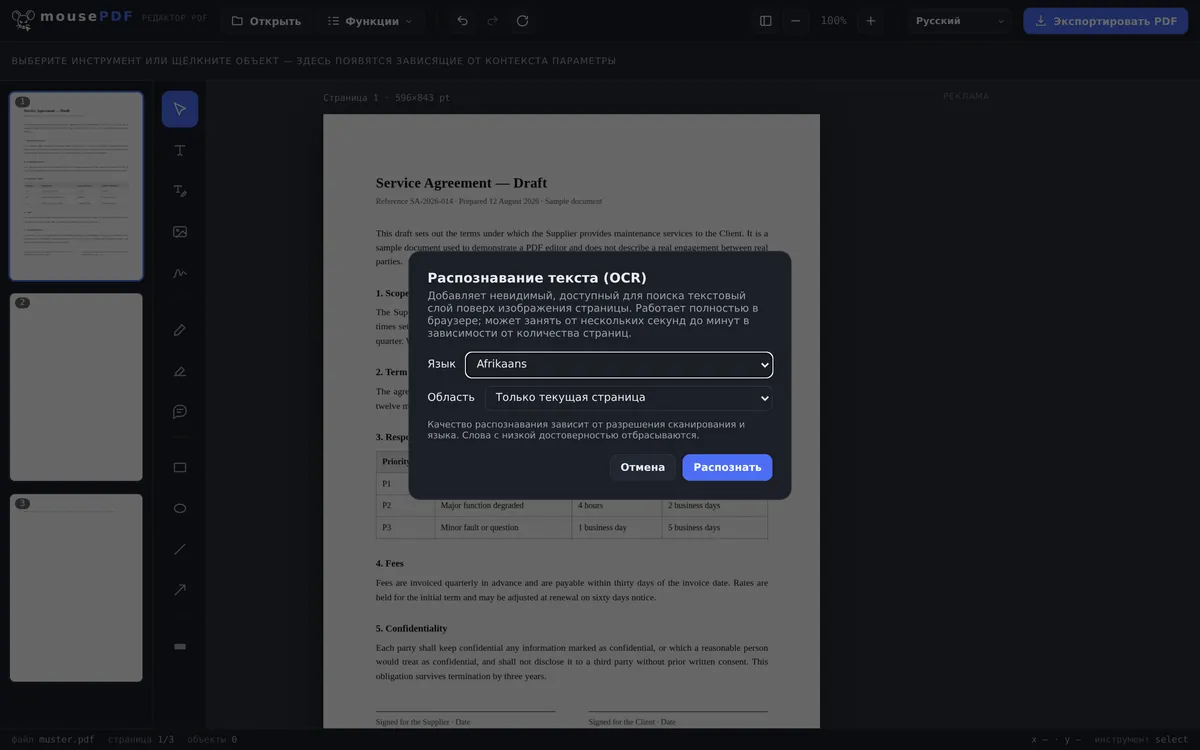
За три шага
Открой PDF
Перетащи отсканированный или основанный на изображениях PDF в окно или выбери его.
Выбери язык и объём
Укажи язык распознавания и реши, нужно ли распознать только текущую страницу или весь документ.
Экспортируй
Сохрани PDF с доступным для поиска, невидимым текстовым слоем — изображение страницы остаётся визуально неизменным.
Типичный случай: сделать отсканированные документы доступными для поиска
Отсканированные договоры, счета или книги часто содержат только изображение страницы, а не настоящий текст — в них нельзя ни искать, ни копировать текст. mousePDF распознаёт текст локально в браузере и накладывает его невидимо поверх изображения, чтобы поиск и копирование работали, при этом внешний вид страницы не меняется.
Распознавание текста в браузере — и что в этом особенного
OCR относится к задачам, для которых обычно почти неизбежно приходится что-то загружать: распознаванию нужна языковая модель, а она обычно находится на сервере. Здесь оно работает в твоём браузере; загружается только модель, но никогда не твой файл.
Это особенно важно именно для тех документов, которые сканируют: договоры, расчётные листки по зарплате, врачебные заключения, копии документов, удостоверяющих личность. Скан — это изображение, и прежде чем он станет доступным для поиска, его должно что-то прочитать. То, что это «что-то» работает на твоём собственном устройстве в твоём браузере, и есть настоящее отличие.
Для OCR доступны 28 языков. Модель выбранного языка подгружается только при фактическом запуске — благодаря этому страница остаётся лёгкой, и ты загружаешь только то, что нужно.
Где распознавание достигает своих границ
Нелатинские системы письма сознательно отсутствуют. Нет ни кириллицы, ни китайского, японского или корейского, ни арабского, иврита, деванагари или тайского. Модели для них значительно больше, а точность распознавания заметно ниже — результат, который приходится исправлять посимвольно, никому не помогает. Греческий включён, потому что в этом отношении он не относится к той же категории.
Распознавание никогда не бывает безошибочным. Оно считывает из пикселей то, что когда-то было текстом. Чистый скан с ровной ориентацией даёт очень хорошие результаты; кривая фотография с телефона при плохом освещении, неразборчивый почерк или необычный декоративный шрифт — заметно худшие. Кто планирует использовать текст дальше, должен его перепроверить — это касается любой версии, обработанной OCR, а не только этой.
Внешний вид страницы не меняется. Распознанный текст накладывается как невидимый слой поверх изображения: ты по-прежнему видишь свой скан, но можешь в нём искать и выделять. Ошибки распознавания поэтому не видны на изображении — они проявляются только тогда, когда ты копируешь текст.
OCR полезен и после сжатия PDF: при этом страницы становятся изображениями и теряют текстовый слой — распознавание текста создаёт его заново.
Частые вопросы
Загружается ли мой документ для распознавания текста? +
Нет. Распознавание полностью происходит в браузере с помощью локально загруженного движка OCR — файл никогда не покидает твоё устройство.
Какие языки поддерживаются? +
Довольно большой выбор европейских языков с латинским или греческим алфавитом. Такие системы письма, как китайская, арабская, кириллица или деванагари, в настоящее время для OCR не поддерживаются.
Сколько времени занимает распознавание? +
В зависимости от количества страниц и мощности устройства — от нескольких секунд до нескольких минут.
Меняет ли распознавание текста внешний вид страницы? +
Нет. Изображение страницы остаётся точно таким же, распознанный текстовый слой находится под ним невидимо — благодаря этому становятся возможны только поиск и копирование.
Насколько хорошо работает распознавание при плохо отсканированных или рукописных документах? +
Распознавание работает лучше всего с чисто напечатанным, хорошо читаемым текстом. При рукописных заметках или сильно зашумлённых сканах точность снижается — тогда отдельные символы могут распознаваться неверно или отсутствовать.
Какие языки распознаются? +
28, все с латинским алфавитом плюс греческий. Нелатинские системы письма, такие как кириллица, китайский, арабский, иврит или тайский, сознательно не включены — точность распознавания там была бы значительно хуже.
Насколько точным является распознавание? +
При чистом, ровном скане — очень хорошим; при кривых фотографиях с телефона, плохом освещении или почерке — заметно хуже. Кто планирует использовать текст дальше, должен его перепроверить.
Выглядит ли мой документ иначе после распознавания текста? +
Нет. Распознанный текст добавляется как невидимый слой поверх изображения — страница выглядит так же, как раньше, но становится доступной для поиска.
Это тоже может пригодиться
Сжатие PDF
Значительно уменьши PDF с большим количеством изображений — страницы при этом становятся изображениями.
Конвертация PDF в PDF/A
Преобразуй в архивный формат PDF/A — для органов власти и долгосрочного хранения.
Конвертация PDF в Word
Экспортируй текст PDF как редактируемый файл Word — без загрузки.
Редактирование текста PDF
Кликни по существующему тексту в PDF и замени его новым.