 mousePDF
PDF-tekstherkenning (OCR) zonder upload
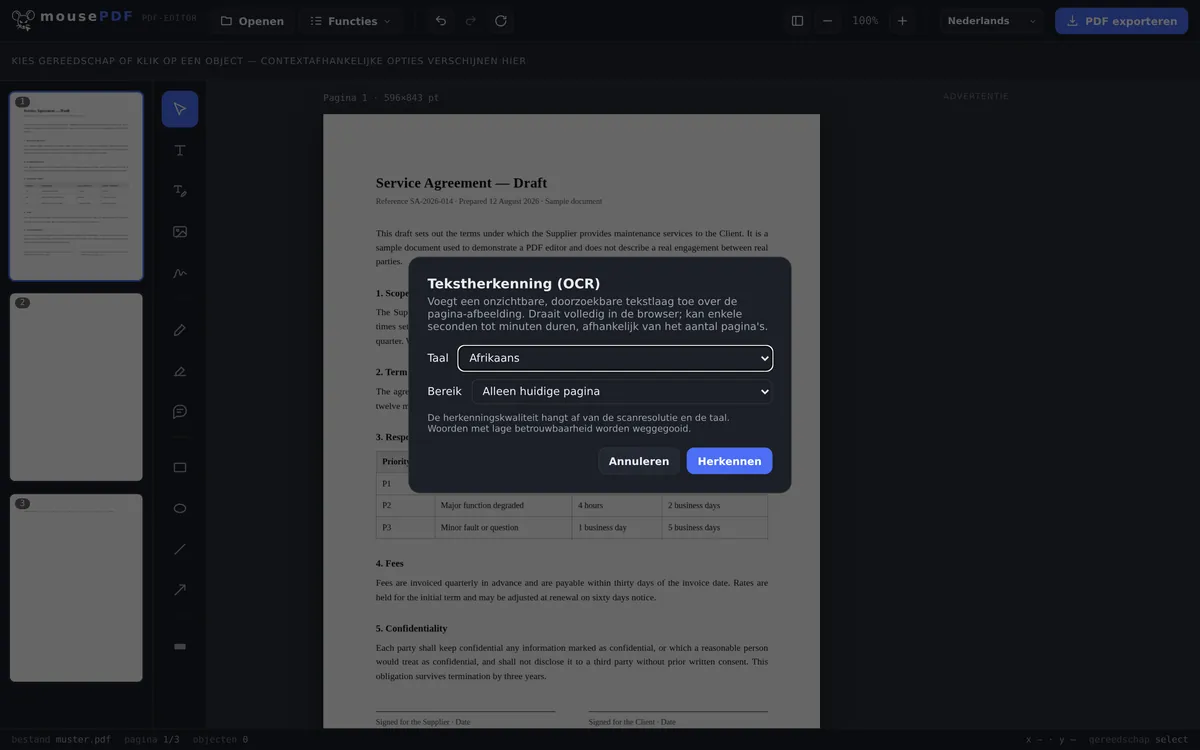
Leg een onzichtbare, doorzoekbare tekstlaag over gescande of als afbeelding aanwezige PDF-pagina's. De herkenning gebeurt volledig in je browser, je bestand wordt nooit geüpload.
In drie stappen
PDF openen
Sleep een gescande of afbeelding-gebaseerde PDF naar het venster of selecteer deze.
Taal & omvang kiezen
Herkenningstaal instellen en bepalen of alleen de huidige pagina of het hele document herkend moet worden.
Exporteren
PDF met doorzoekbare, onzichtbare tekstlaag opslaan. Het paginabeeld blijft visueel ongewijzigd.
Gescande documenten doorzoekbaar maken
Ingescande contracten, facturen of boeken bevatten vaak alleen een paginabeeld, geen echte tekst, je kunt er niet in zoeken of tekst uit kopiëren. mousePDF herkent de tekst lokaal in de browser en legt die onzichtbaar over de afbeelding, zodat zoeken en kopiëren werken zonder dat er iets aan het uiterlijk van de pagina verandert.
Waarom herkenning op je eigen apparaat ongebruikelijk is
OCR is een van de taken waarvoor je anders bijna altijd iets moet uploaden: de herkenning heeft een taalmodel nodig, en dat staat meestal op een server. Hier draait het in je browser; alleen het model wordt geladen, nooit je bestand.
Dat is juist belangrijk bij de documenten die je scant: contracten, loonstroken, medische brieven, kopieën van identiteitsbewijzen. Een scan is een afbeelding, en voordat die doorzoekbaar wordt, moet iets hem lezen. Dat dit iets op je eigen apparaat in je browser draait, is het eigenlijke verschil.
28 talen zijn beschikbaar voor OCR. Het model van de gekozen taal wordt pas bij de daadwerkelijke uitvoering nageladen. De pagina blijft daardoor licht, en je laadt alleen wat je nodig hebt.
Waar de herkenning aan zijn grenzen komt
Niet-Latijnse schriften ontbreken bewust. Geen Cyrillisch, geen Chinees, Japans of Koreaans, geen Arabisch, Hebreeuws, Devanagari of Thai. De modellen daarvoor zijn aanzienlijk groter en het trefpercentage merkbaar lager, een resultaat dat je teken voor teken moet corrigeren, helpt niemand. Grieks is er wel bij, omdat het in dit opzicht niet in dezelfde categorie valt.
De herkenning is nooit foutloos. Ze leest uit pixels terug wat ooit tekst was. Een schone scan met rechte uitlijning levert zeer goede resultaten op; een scheve telefoonfoto bij slecht licht, een krabbelig handschrift of een ongebruikelijk sierlettertype merkbaar slechtere. Wie de tekst hergebruikt, moet hem nalezen, dat geldt voor elke door OCR bewerkte versie, niet alleen deze.
Het uiterlijk van de pagina verandert niet. De herkende tekst wordt als onzichtbare laag over de afbeelding gelegd: je ziet nog steeds je scan, maar kunt erin zoeken en markeren. Herkenningsfouten zijn daardoor niet zichtbaar in de afbeelding. Ze blijken pas als je tekst uitkopieert.
OCR is ook nuttig na het comprimeren van een PDF: daarbij worden pagina's afbeeldingen en verliezen ze hun tekstlaag, de tekstherkenning legt die opnieuw aan.
Veelgestelde vragen
Wordt mijn document geüpload voor de tekstherkenning? +
Nee. De herkenning gebeurt volledig in de browser via een lokaal geladen OCR-engine, het bestand verlaat nooit je apparaat.
Welke talen worden ondersteund? +
Een ruime selectie Europese talen met Latijns of Grieks schrift. Schriften zoals Chinees, Arabisch, Cyrillisch of Devanagari worden momenteel niet ondersteund voor OCR.
Hoe lang duurt de herkenning? +
Afhankelijk van het aantal pagina's en de apparaatprestaties enkele seconden tot een paar minuten.
Verandert de tekstherkenning het uiterlijk van de pagina? +
Nee. Het paginabeeld blijft exact gelijk, de herkende tekstlaag ligt er onzichtbaar overheen, alleen zoeken en kopiëren worden daardoor mogelijk.
Hoe goed is de herkenning bij slecht gescande of handgeschreven documenten? +
De herkenning werkt het best bij netjes gedrukte, goed leesbare teksten. Bij handgeschreven notities of sterk ruizende scans daalt de nauwkeurigheid; dan kunnen losse tekens verkeerd worden herkend of ontbreken.
Welke talen worden herkend? +
28, allemaal met Latijns schrift plus Grieks. Niet-Latijnse schriften zoals Cyrillisch, Chinees, Arabisch, Hebreeuws of Thai zijn bewust niet erbij, het trefpercentage zou daar aanzienlijk slechter zijn.
Hoe nauwkeurig is de herkenning? +
Bij een schone, rechte scan zeer goed; bij scheve telefoonfoto's, slecht licht of handschrift merkbaar slechter. Wie de tekst hergebruikt, moet hem nalezen.
Ziet mijn document er na de tekstherkenning anders uit? +
Nee. De herkende tekst komt als onzichtbare laag over de afbeelding, de pagina ziet eruit als voorheen, maar is doorzoekbaar.
Dit kan ook helpen
PDF comprimeren
Beeldzware PDF's flink verkleinen, de pagina's worden daarbij afbeeldingen.
PDF naar PDF/A converteren
Omzetten naar het archiefvriendelijke PDF/A-formaat, voor overheidsinstanties en langetermijnopslag.
PDF naar Word converteren
PDF-tekst exporteren als bewerkbaar Word-bestand, zonder upload.
PDF-tekst bewerken
Klik op bestaande tekst in de PDF en vervang deze door nieuwe tekst.