 mousePDF
PDF-textigenkänning (OCR) — utan uppladdning
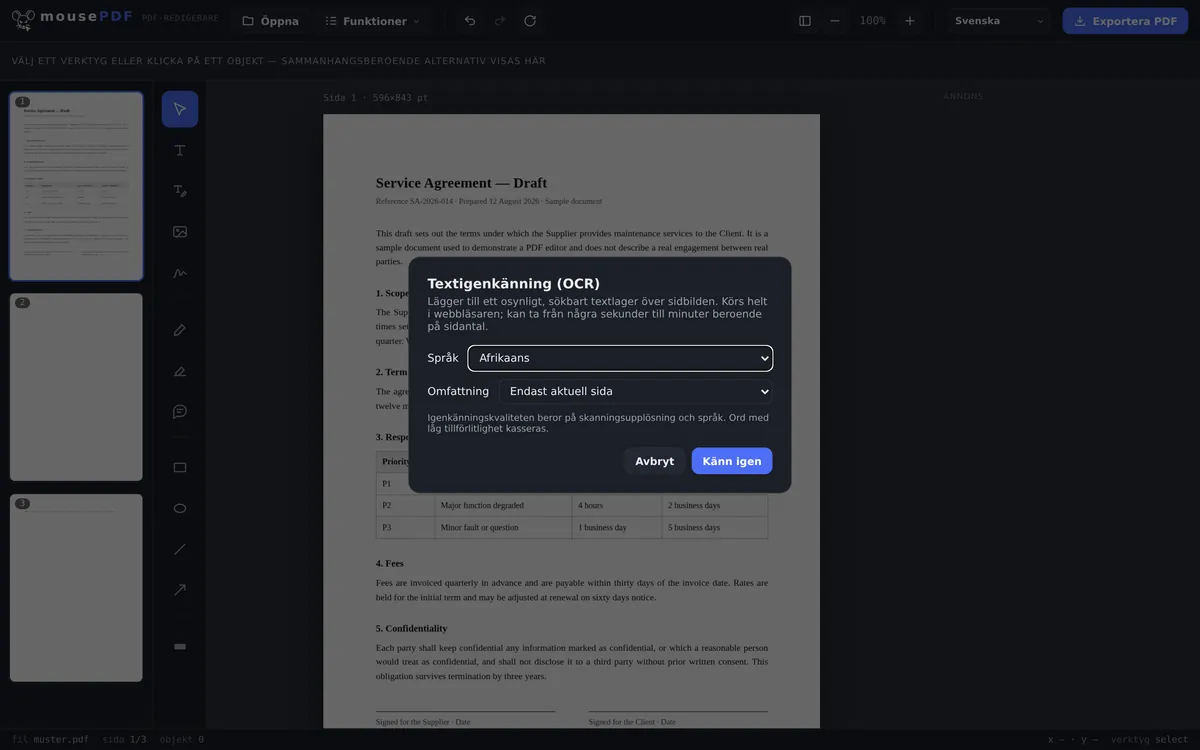
Lägg ett osynligt, sökbart textlager över skannade eller bildbaserade PDF-sidor. Igenkänningen sker helt i din webbläsare, din fil laddas aldrig upp.
I tre steg
Öppna PDF
Dra in den skannade eller bildbaserade PDF-filen eller välj den.
Välj språk & omfattning
Ange igenkänningsspråk och bestäm om bara aktuell sida eller hela dokumentet ska bearbetas.
Exportera
Spara PDF med sökbart, osynligt textlager — sidbilden förblir visuellt oförändrad.
Typiskt fall: göra skannade dokument sökbara
Skannade avtal, fakturor eller böcker innehåller ofta bara en sidbild, ingen riktig text — man kan varken söka i dem eller kopiera text. mousePDF känner igen texten lokalt i webbläsaren och lägger den osynligt över bilden, så att sökning och kopiering fungerar utan att sidans utseende förändras.
Textigenkänning i webbläsaren — och vad som är speciellt med det
OCR hör till de uppgifter man annars nästan alltid måste ladda upp något för: igenkänningen behöver en språkmodell, och den ligger vanligtvis på en server. Här körs den i din webbläsare; bara modellen laddas, aldrig din fil.
Det är just viktigt för de dokument man skannar: avtal, lönebesked, läkarintyg, kopior av id-handlingar. En skanning är en bild — och innan den blir sökbar måste något läsa den. Att det något körs på din egen enhet i din webbläsare är den egentliga skillnaden.
28 språk finns tillgängliga för OCR. Modellen för det valda språket laddas först vid den faktiska körningen — sidan förblir därför lätt, och du laddar bara det du behöver.
Var igenkänningen når sina gränser
Icke-latinska skriftsystem saknas medvetet. Ingen kyrilliska, inget kinesiska, japanska eller koreanska, ingen arabiska, hebreiska, devanagari eller thailändska. Modellerna för dessa är betydligt större och träffsäkerheten märkbart lägre — ett resultat man måste rätta tecken för tecken hjälper ingen. Grekiska finns med, eftersom det i det här avseendet inte hamnar i samma klass.
Igenkänningen är aldrig felfri. Den läser tillbaka från pixlar det som en gång var text. En ren skanning med rak inriktning ger mycket goda resultat; ett snett mobilfoto i dåligt ljus, en kladdig handskrift eller ett ovanligt dekorativt typsnitt betydligt sämre. Den som återanvänder texten bör läsa igenom den — det gäller alla OCR-bearbetade versioner, inte bara den här.
Sidans utseende ändras inte. Den igenkända texten läggs som ett osynligt lager över bilden: du ser fortfarande din skanning, men kan söka och markera i den. Igenkänningsfel syns därför inte i bilden — de visar sig först när du kopierar ut text.
OCR är också användbart efter komprimering av en PDF: då blir sidorna till bilder och förlorar sitt textlager — textigenkänningen skapar det på nytt.
Vanliga frågor
Laddas mitt dokument upp för textigenkänningen? +
Nej. Igenkänningen sker helt i webbläsaren via en lokalt laddad OCR-motor — filen lämnar aldrig din enhet.
Vilka språk stöds? +
Ett större urval europeiska språk med latinsk eller grekisk skrift. Skriftsystem som kinesiska, arabiska, kyrilliska eller devanagari stöds för närvarande inte för OCR.
Hur lång tid tar igenkänningen? +
Beroende på antal sidor och enhetens prestanda, några sekunder till några minuter.
Ändrar textigenkänningen sidans utseende? +
Nej. Sidbilden förblir exakt densamma, det igenkända textlagret ligger osynligt ovanpå — bara sökning och kopiering blir möjliga genom det.
Hur bra är igenkänningen på dåligt skannade eller handskrivna dokument? +
Igenkänningen fungerar bäst på snyggt tryckt, lättläst text. Vid handskrivna anteckningar eller kraftigt brusiga skanningar sjunker noggrannheten — då kan enstaka tecken kännas igen fel eller saknas.
Vilka språk känns igen? +
28, alla med latinsk skrift plus grekiska. Icke-latinska skriftsystem som kyrilliska, kinesiska, arabiska, hebreiska eller thailändska är medvetet inte med — träffsäkerheten skulle vara betydligt sämre där.
Hur exakt är igenkänningen? +
Vid en ren, rak skanning mycket bra; vid sneda mobilfoton, dåligt ljus eller handskrift märkbart sämre. Den som återanvänder texten bör läsa igenom den.
Ser mitt dokument annorlunda ut efter textigenkänningen? +
Nej. Den igenkända texten kommer som ett osynligt lager över bilden — sidan ser ut som förut, men är sökbar.
Detta kan också hjälpa
Komprimera PDF
Förminska bildtunga PDF-filer avsevärt — sidorna blir då till bilder.
Konvertera PDF till PDF/A
Konvertera till det arkivvänliga PDF/A-formatet — för myndigheter och långtidsarkivering.
Konvertera PDF till Word
Exportera PDF-text som en redigerbar Word-fil — utan uppladdning.
Redigera PDF-text
Klicka på befintlig text i PDF-filen och ersätt den med ny.