 mousePDF
Reconocimiento de texto en PDF (OCR) sin subir archivos
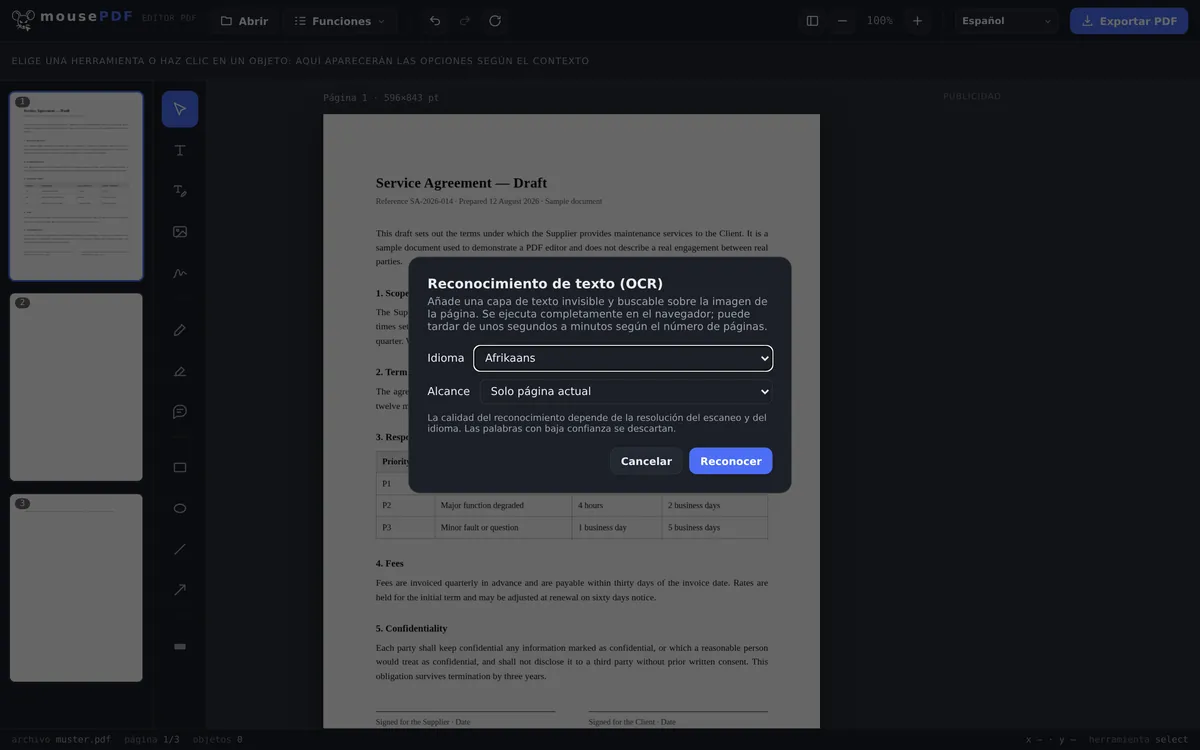
Añade una capa de texto invisible y buscable sobre páginas de PDF escaneadas o en forma de imagen. El reconocimiento se realiza por completo en tu navegador, tu archivo nunca se sube.
En tres pasos
Abrir el PDF
Arrastra a la ventana un PDF escaneado o basado en imágenes, o selecciónalo.
Elegir idioma y alcance
Define el idioma de reconocimiento y decide si se procesa solo la página actual o todo el documento.
Exportar
Guarda el PDF con una capa de texto invisible y buscable. La imagen de la página no cambia visualmente.
Hacer buscables los documentos escaneados
Los contratos, facturas o libros escaneados suelen contener solo la imagen de la página, sin texto real, no se puede buscar ni copiar texto en ellos. mousePDF reconoce el texto localmente en el navegador y lo coloca de forma invisible sobre la imagen, de modo que la búsqueda y la copia funcionan sin que cambie el aspecto de la página.
Por qué el reconocimiento en tu propio dispositivo es poco habitual
El OCR es una de esas tareas para las que normalmente casi es inevitable subir algo: el reconocimiento necesita un modelo de idioma, y este suele estar alojado en un servidor. Aquí se ejecuta en tu navegador; solo se descarga el modelo, nunca tu archivo.
Esto es justo lo importante en los documentos que se escanean: contratos, nóminas, informes médicos, copias del DNI. Un escaneo es una imagen, y antes de que sea buscable, algo tiene que leerlo. Que ese «algo» se ejecute en tu propio dispositivo, en tu navegador, es la verdadera diferencia.
Hay 28 idiomas disponibles para el OCR. El modelo del idioma elegido solo se descarga al ejecutar el reconocimiento. Así la página se mantiene ligera y solo descargas lo que necesitas.
Dónde llega el reconocimiento a sus límites
Las escrituras no latinas faltan deliberadamente. Nada de cirílico, ni chino, japonés o coreano, ni árabe, hebreo, devanagari o tailandés. Los modelos para esas escrituras son notablemente más grandes y la tasa de acierto claramente más baja, un resultado que hay que corregir carácter por carácter no le sirve a nadie. El griego sí está incluido, porque en este aspecto no entra en la misma categoría.
El reconocimiento nunca es perfecto. Reconstruye a partir de píxeles lo que una vez fue texto. Un escaneo limpio y bien alineado da muy buenos resultados; una foto de móvil torcida con mala luz, una letra manuscrita descuidada o una tipografía decorativa poco habitual, resultados notablemente peores. Quien reutilice el texto debería revisarlo, esto vale para cualquier OCR, no solo para este.
El aspecto de la página no cambia. El texto reconocido se coloca como una capa invisible sobre la imagen: sigues viendo tu escaneo, pero ahora puedes buscar y seleccionar en él. Por eso los errores de reconocimiento no se ven en la imagen. Solo aparecen cuando copias el texto.
El OCR también es útil después de comprimir un PDF: en ese proceso las páginas se convierten en imágenes y pierden su capa de texto, el reconocimiento de texto la vuelve a crear.
Preguntas frecuentes
¿Se sube mi documento para el reconocimiento de texto? +
No. El reconocimiento se ejecuta por completo en el navegador mediante un motor de OCR cargado localmente, el archivo nunca sale de tu dispositivo.
¿Qué idiomas son compatibles? +
Una amplia selección de idiomas europeos con escritura latina o griega. Escrituras como el chino, el árabe, el cirílico o el devanagari no son compatibles actualmente con el OCR.
¿Cuánto tarda el reconocimiento? +
Según el número de páginas y la potencia del dispositivo, de unos segundos a pocos minutos.
¿El reconocimiento de texto cambia el aspecto de la página? +
No. La imagen de la página se mantiene exactamente igual, la capa de texto reconocida queda invisible sobre ella, solo se habilitan la búsqueda y la copia.
¿Qué tan buena es la precisión con documentos mal escaneados o manuscritos? +
El reconocimiento funciona mejor con textos impresos limpios y bien legibles. Con notas manuscritas o escaneos muy ruidosos, la precisión baja; pueden reconocerse mal caracteres sueltos o faltar directamente.
¿Qué idiomas se reconocen? +
28, todos con escritura latina más el griego. Las escrituras no latinas como el cirílico, el chino, el árabe, el hebreo o el tailandés se han dejado fuera deliberadamente, ahí la tasa de acierto sería notablemente peor.
¿Qué tan precisa es la detección? +
Muy buena con un escaneo limpio y recto; notablemente peor con fotos de móvil torcidas, mala luz o letra manuscrita. Quien reutilice el texto debería revisarlo.
¿Mi documento se ve distinto después del reconocimiento de texto? +
No. El texto reconocido se añade como una capa invisible sobre la imagen, la página se ve como antes, pero ahora es buscable.
Esto también te puede ayudar
Comprimir PDF
Reduce notablemente el tamaño de PDF con muchas imágenes, las páginas se convierten en imágenes.
Convertir PDF a PDF/A
Convierte al formato PDF/A, apto para archivo, para administraciones y almacenamiento a largo plazo.
Convertir PDF a Word
Exporta el texto del PDF como un archivo de Word editable, sin subir archivos.
Editar texto del PDF
Haz clic en el texto existente del PDF y sustitúyelo por uno nuevo.