 mousePDF
Rozpoznawanie tekstu w PDF (OCR) — bez wysyłania
Nałóż niewidoczną, przeszukiwalną warstwę tekstu na zeskanowane lub obrazowe strony PDF. Rozpoznawanie odbywa się w całości w Twojej przeglądarce, Twój plik nigdy nie jest wysyłany.
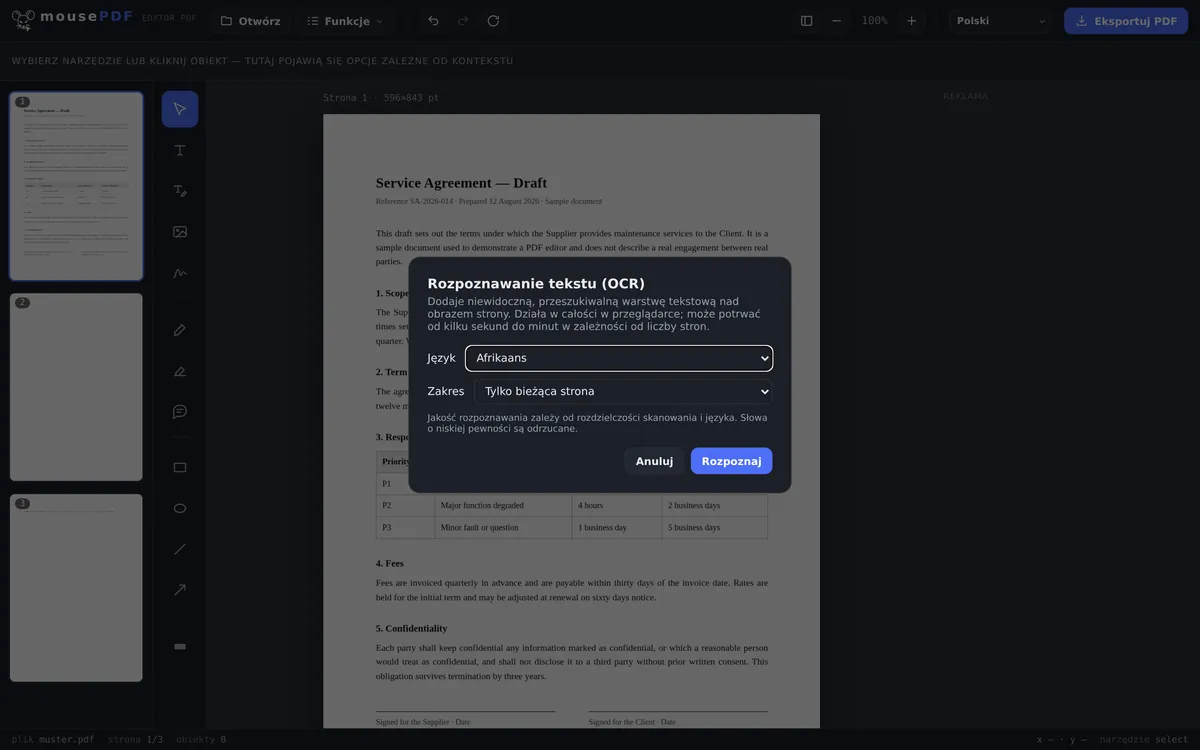
W trzech krokach
Otwórz PDF
Przeciągnij zeskanowany lub obrazowy PDF do okna albo wybierz go.
Wybierz język i zakres
Ustaw język rozpoznawania i zdecyduj, czy rozpoznana ma być tylko bieżąca strona, czy cały dokument.
Eksportuj
Zapisz PDF z przeszukiwalną, niewidoczną warstwą tekstu — obraz strony pozostaje wizualnie niezmieniony.
Typowy przypadek: uczynienie zeskanowanych dokumentów przeszukiwalnymi
Zeskanowane umowy, faktury czy książki często zawierają tylko obraz strony, żaden prawdziwy tekst — nie da się w nich niczego wyszukać ani skopiować tekstu. mousePDF rozpoznaje tekst lokalnie w przeglądarce i nakłada go niewidocznie na obraz, dzięki czemu wyszukiwanie i kopiowanie działają, a wygląd strony się nie zmienia.
Rozpoznawanie tekstu w przeglądarce — i co jest w tym szczególne
OCR należy do zadań, przy których zwykle nie da się uniknąć wysyłania czegokolwiek: rozpoznawanie potrzebuje modelu językowego, a ten zwykle leży na serwerze. Tutaj działa w Twojej przeglądarce; ładowany jest tylko model, nigdy Twój plik.
To ważne właśnie przy dokumentach, które się skanuje: umowy, odcinki wypłat, dokumentacja medyczna, kopie dowodów tożsamości. Skan to obraz — a zanim stanie się przeszukiwalny, coś musi go odczytać. To, że to coś działa na Twoim własnym urządzeniu, w Twojej przeglądarce, jest właściwą różnicą.
28 języków jest dostępnych dla OCR. Model wybranego języka jest doładowywany dopiero przy faktycznym uruchomieniu — dzięki temu strona pozostaje lekka, a Ty pobierasz tylko to, czego potrzebujesz.
Gdzie rozpoznawanie napotyka swoje granice
Pisma niełacińskie celowo nie są obsługiwane. Brak cyrylicy, chińskiego, japońskiego czy koreańskiego, brak arabskiego, hebrajskiego, dewanagari czy tajskiego. Modele dla nich są znacznie większe, a skuteczność wyraźnie niższa — wynik, który trzeba poprawiać znak po znaku, nikomu nie pomaga. Grecki jest dostępny, bo pod tym względem nie należy do tej samej kategorii.
Rozpoznawanie nigdy nie jest bezbłędne. Odczytuje z pikseli to, co kiedyś było tekstem. Czysty skan z prostym ustawieniem daje bardzo dobre wyniki; krzywe zdjęcie telefonem przy słabym świetle, niewyraźne pismo odręczne lub nietypowa czcionka ozdobna — wyraźnie gorsze. Kto dalej wykorzystuje tekst, powinien go sprawdzić — dotyczy to każdej wersji przetworzonej przez OCR, nie tylko tej.
Wygląd strony się nie zmienia. Rozpoznany tekst zostaje nałożony jako niewidoczna warstwa na obraz: nadal widzisz swój skan, ale możesz w nim wyszukiwać i zaznaczać. Błędy rozpoznawania nie są więc widoczne na obrazie — ujawniają się dopiero, gdy skopiujesz tekst.
OCR przydaje się też po skompresowaniu pliku PDF: wtedy strony stają się obrazami i tracą swoją warstwę tekstową — rozpoznawanie tekstu odtwarza ją na nowo.
Najczęściej zadawane pytania
Czy mój dokument jest wysyłany do rozpoznawania tekstu? +
Nie. Rozpoznawanie odbywa się w całości w przeglądarce, za pomocą lokalnie załadowanego silnika OCR — plik nigdy nie opuszcza Twojego urządzenia.
Jakie języki są obsługiwane? +
Szerszy wybór języków europejskich z pismem łacińskim lub greckim. Pisma takie jak chińskie, arabskie, cyrylica czy dewanagari nie są obecnie obsługiwane dla OCR.
Jak długo trwa rozpoznawanie? +
W zależności od liczby stron i wydajności urządzenia od kilku sekund do kilku minut.
Czy rozpoznawanie tekstu zmienia wygląd strony? +
Nie. Obraz strony pozostaje dokładnie taki sam, rozpoznana warstwa tekstu leży nad nim niewidocznie — dzięki temu możliwe stają się tylko wyszukiwanie i kopiowanie.
Jak dobre jest rozpoznawanie przy słabo zeskanowanych lub odręcznych dokumentach? +
Rozpoznawanie działa najlepiej przy czysto wydrukowanych, dobrze czytelnych tekstach. Przy odręcznych notatkach lub mocno zaszumionych skanach dokładność spada — wtedy pojedyncze znaki mogą być rozpoznane błędnie lub w ogóle pominięte.
Jakie języki są rozpoznawane? +
28, wszystkie z pismem łacińskim plus grecki. Pisma niełacińskie, jak cyrylica, chiński, arabski, hebrajski czy tajski, celowo nie są uwzględnione — skuteczność byłaby tam wyraźnie gorsza.
Jak dokładne jest rozpoznawanie? +
Przy czystym, prostym skanie bardzo dobre; przy krzywych zdjęciach z telefonu, słabym świetle lub piśmie odręcznym wyraźnie gorsze. Kto dalej wykorzystuje tekst, powinien go sprawdzić.
Czy mój dokument wygląda inaczej po rozpoznaniu tekstu? +
Nie. Rozpoznany tekst pojawia się jako niewidoczna warstwa nad obrazem — strona wygląda jak wcześniej, ale jest przeszukiwalna.
To też może pomóc
Kompresowanie PDF
Znacząco zmniejsz PDF-y z dużą liczbą obrazów — strony stają się przy tym obrazami.
Konwersja PDF do PDF/A
Zamień na przyjazny dla archiwizacji format PDF/A — dla urzędów i długoterminowego przechowywania.
Konwersja PDF do Word
Eksportuj tekst PDF jako edytowalny plik Word — bez wysyłania.
Edycja tekstu PDF
Kliknij istniejący tekst w PDF i zastąp go nowym.