 mousePDF
PDF-teksherkenning (OCR) — sonder oplaai
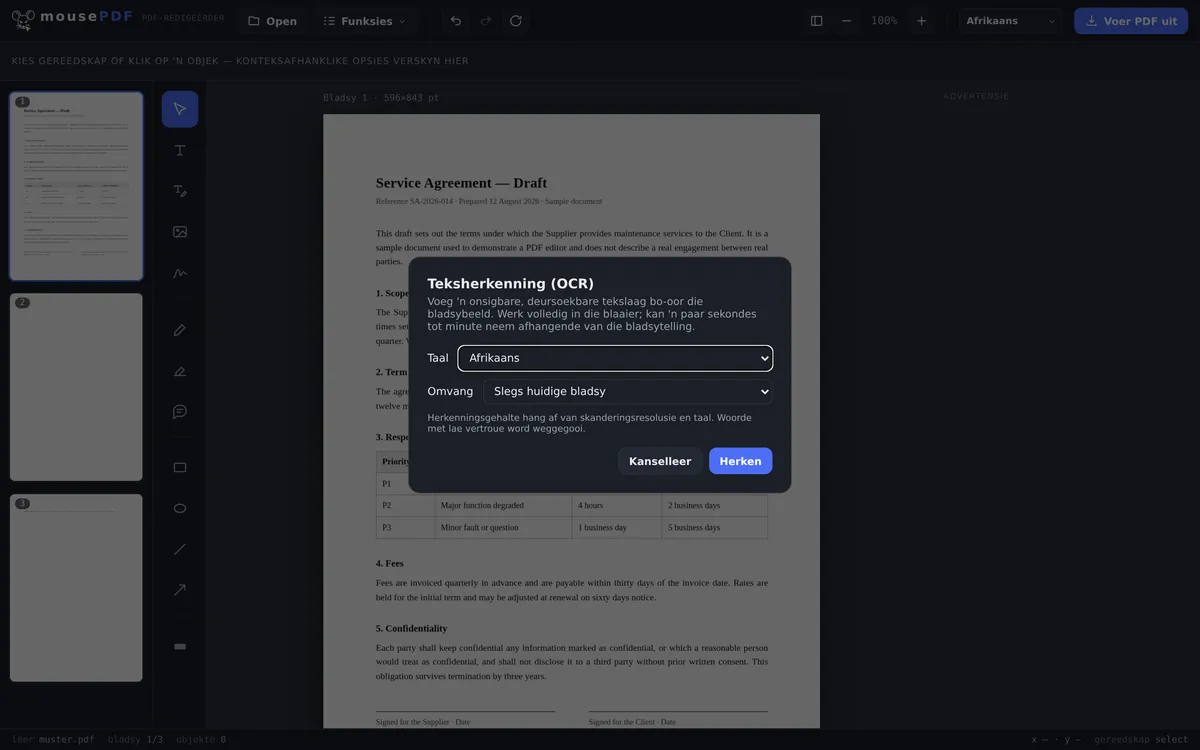
Plaas 'n onsigbare, deursoekbare tekslaag oor geskandeerde of as beeld voorliggende PDF-bladsye. Die herkenning loop heeltemal in jou blaaier, jou lêer word nooit opgelaai nie.
In drie stappe
Maak 'n PDF oop
Sleep 'n geskandeerde of beeldgebaseerde PDF met sleep-en-los in die venster, of kies dit.
Kies taal & omvang
Stel die herkenningstaal vas en besluit of net die huidige bladsy of die hele dokument herken moet word.
Voer uit
Stoor die PDF met 'n deursoekbare, onsigbare tekslaag — die bladsybeeld bly visueel onveranderd.
Tipiese geval: maak geskandeerde dokumente deursoekbaar
Geskandeerde kontrakte, fakture of boeke bevat dikwels net 'n bladsybeeld, geen egte teks nie — 'n mens kan daarin nie soek of teks kopieer nie. mousePDF herken die teks plaaslik in die blaaier en plaas dit onsigbaar oor die beeld, sodat soektog en kopieer werk, sonder dat iets aan die voorkoms van die bladsy verander.
Teksherkenning in die blaaier — en wat daaraan besonders is
OCR is een van die take waarvoor 'n mens andersins byna onvermydelik iets oplaai: die herkenning het 'n taalmodel nodig, en dit lê gewoonlik op 'n bediener. Hier loop dit in jou blaaier; slegs die model word gelaai, nooit jou lêer nie.
Dit is presies belangrik by die dokumente wat 'n mens skandeer: kontrakte, salarisstate, dokterbriewe, ID-kopieë. 'n Skandering is 'n beeld — en voordat dit deursoekbaar word, moet iets dit lees. Dat hierdie iets op jou eie toestel in jou blaaier loop, is die werklike verskil.
28 tale is beskikbaar vir OCR. Die model van die gekose taal word eers tydens die werklike loop nagelaai — die bladsy bly daardeur lig, en jy laai net wat jy nodig het.
Waar die herkenning sy grense bereik
Nie-Latynse skrifte ontbreek doelbewus. Geen Cyrillies nie, geen Chinees, Japannees of Koreaans nie, geen Arabies, Hebreeus, Devanagari of Thai nie. Die modelle daarvoor is aansienlik groter en die trefferkoers merkbaar laer — 'n resultaat wat 'n mens karakter vir karakter moet regmaak, help niemand nie. Grieks is wel ingesluit, omdat dit in hierdie opsig nie in dieselfde klas val nie.
Die herkenning is nooit foutvry nie. Dit lees uit pieksels terug wat eens teks was. 'n Skoon skandering met reguit oriëntasie lewer baie goeie resultate; 'n skewe selfoonfoto in swak lig, 'n krabbelrige handskrif of 'n ongewone sierlettertipe merkbaar swakker. Wie die teks verder gebruik, behoort dit na te gaan — dit geld vir enige OCR-bewerkte weergawe, nie net hierdie een nie.
Die voorkoms van die bladsy verander nie. Die herkende teks word as 'n onsigbare laag oor die beeld gelê: jy sien steeds jou skandering, maar kan daarin soek en merk. Herkenningsfoute is dus nie in die beeld sigbaar nie — hulle wys eers wanneer jy teks uitkopieer.
OCR is ook nuttig na die kompaktering van 'n PDF: daarby word bladsye na beelde omgeskakel en verloor hulle tekslaag — die teksherkenning lê dit opnuut aan.
Gereelde vrae
Word my dokument vir die teksherkenning opgelaai? +
Nee. Die herkenning loop heeltemal in die blaaier via 'n plaaslik gelaaide OCR-enjin — die lêer verlaat nooit jou toestel nie.
Watter tale word ondersteun? +
'n Groot verskeidenheid Europese tale met Latynse of Griekse skrif. Skrifte soos Chinees, Arabies, Cyrillies of Devanagari word tans nie vir OCR ondersteun nie.
Hoe lank duur die herkenning? +
Na gelang van die aantal bladsye en toestelvermoë, 'n paar sekondes tot enkele minute.
Verander die teksherkenning die voorkoms van die bladsy? +
Nee. Die bladsybeeld bly presies dieselfde, die herkende tekslaag lê onsigbaar daaroor — slegs soek en kopieer word daardeur moontlik.
Hoe goed is die herkenning by swak geskandeerde of handgeskrewe dokumente? +
Die herkenning werk die beste by netjies gedrukte, goed leesbare tekste. By handgeskrewe notas of sterk geruisde skanderings daal die akkuraatheid — dan kan enkele karakters verkeerd herken word of ontbreek.
Watter tale word herken? +
28, almal met Latynse skrif plus Grieks. Nie-Latynse skrifte soos Cyrillies, Chinees, Arabies, Hebreeus of Thai is doelbewus nie ingesluit nie — die trefferkoers sou daar merkbaar swakker wees.
Hoe akkuraat is die herkenning? +
By 'n skoon, reguit skandering baie goed; by skewe selfoonfoto's, swak lig of handskrif merkbaar swakker. Wie die teks verder gebruik, behoort dit na te gaan.
Lyk my dokument na die teksherkenning anders? +
Nee. Die herkende teks kom as 'n onsigbare laag oor die beeld — die bladsy lyk soos voorheen, maar is deursoekbaar.
Dit kan ook help
PDF kompakteer
Verklein beeld-swaar PDF's aansienlik — die bladsye word daarby na beelde omgeskakel.
Skakel PDF na PDF/A om
Skakel om na die argiefvriendelike PDF/A-formaat — vir owerhede en langtermynstoor.
Skakel PDF na Word om
Voer PDF-teks uit as 'n redigeerbare Word-lêer — sonder oplaai.
Redigeer PDF-teks
Klik bestaande teks in die PDF aan en vervang dit met nuwe teks.