 mousePDF
Pengenalan Teks PDF (OCR) — tanpa unggah
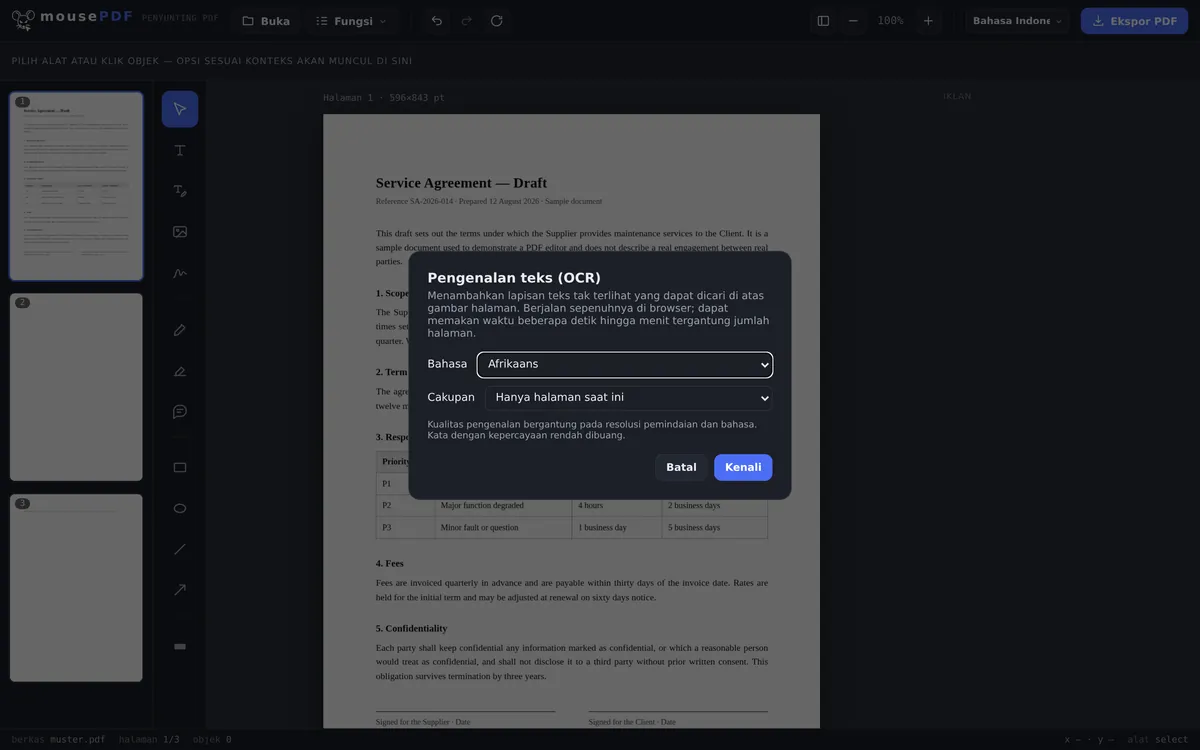
Tambahkan lapisan teks yang tidak terlihat dan bisa dicari di atas halaman PDF hasil pindaian atau berupa gambar. Pengenalan berjalan sepenuhnya di browsermu, filemu tidak pernah diunggah.
Dalam tiga langkah
Buka PDF
Seret PDF hasil pindaian atau berbasis gambar ke jendela, atau pilih dari perangkat.
Pilih bahasa & cakupan
Tentukan bahasa pengenalan dan pilih apakah hanya halaman saat ini atau seluruh dokumen yang akan dikenali.
Ekspor
Simpan PDF dengan lapisan teks yang bisa dicari dan tidak terlihat — tampilan halaman tetap tidak berubah.
Kasus umum: membuat dokumen hasil pindaian bisa dicari
Kontrak, faktur, atau buku hasil pindaian sering kali hanya berupa gambar halaman, bukan teks asli — kamu tidak bisa mencari atau menyalin teks di dalamnya. mousePDF mengenali teksnya secara lokal di browser dan menempatkannya secara tidak terlihat di atas gambar, sehingga pencarian dan penyalinan berfungsi tanpa mengubah tampilan halaman.
Pengenalan teks di browser — dan apa yang membuatnya istimewa
OCR termasuk tugas yang biasanya hampir selalu memaksa kamu mengunggah sesuatu: pengenalan butuh model bahasa, dan itu biasanya ada di server. Di sini, prosesnya berjalan di browsermu; yang dimuat hanyalah modelnya, bukan filemu.
Ini penting justru untuk dokumen yang biasa dipindai orang: kontrak, slip gaji, surat dokter, salinan kartu identitas. Hasil pindaian adalah gambar — dan sebelum bisa dicari, sesuatu harus membacanya lebih dulu. Fakta bahwa proses ini berjalan di perangkatmu sendiri, di browsermu, adalah perbedaan sesungguhnya.
Tersedia 28 bahasa untuk OCR. Model bahasa yang dipilih baru dimuat saat proses benar-benar dijalankan — halamannya tetap ringan, dan kamu hanya memuat apa yang kamu butuhkan.
Di mana batas pengenalan ini
Aksara non-Latin sengaja tidak disertakan. Tidak ada Sirilik, tidak ada Tionghoa, Jepang, atau Korea, tidak ada Arab, Ibrani, Devanagari, atau Thai. Model untuk aksara-aksara itu jauh lebih besar dan tingkat keberhasilannya jelas lebih rendah — hasil yang harus dikoreksi karakter demi karakter tidak membantu siapa pun. Yunani tetap disertakan karena dari segi ini tidak termasuk dalam kelompok yang sama.
Pengenalan ini tidak pernah bebas kesalahan. Ia membaca kembali dari piksel apa yang dulunya teks. Hasil pindaian yang bersih dan lurus memberikan hasil yang sangat baik; foto ponsel yang miring dengan cahaya buruk, tulisan tangan yang berantakan, atau huruf hias yang tidak biasa memberikan hasil yang jelas lebih buruk. Siapa pun yang memakai ulang teksnya sebaiknya memeriksanya kembali — ini berlaku untuk hasil OCR apa pun, bukan hanya yang ini.
Tampilan halaman tidak berubah. Teks yang dikenali diletakkan sebagai lapisan tidak terlihat di atas gambar: kamu tetap melihat hasil pindaianmu, tapi bisa mencari dan menyorot teks di dalamnya. Karena itu, kesalahan pengenalan tidak terlihat pada gambar — baru terlihat saat kamu menyalin teksnya keluar.
OCR juga berguna setelah mengompres PDF: proses itu mengubah halaman menjadi gambar dan menghilangkan lapisan teksnya — pengenalan teks membuatnya kembali.
Pertanyaan yang Sering Diajukan
Apakah dokumen saya diunggah untuk pengenalan teks ini? +
Tidak. Pengenalan berjalan sepenuhnya di browser lewat mesin OCR yang dimuat secara lokal — filenya tidak pernah meninggalkan perangkatmu.
Bahasa apa saja yang didukung? +
Sejumlah besar bahasa Eropa dengan aksara Latin atau Yunani. Aksara seperti Tionghoa, Arab, Sirilik, atau Devanagari saat ini belum didukung untuk OCR.
Berapa lama proses pengenalannya? +
Tergantung jumlah halaman dan kemampuan perangkat, mulai dari beberapa detik hingga beberapa menit.
Apakah pengenalan teks mengubah tampilan halaman? +
Tidak. Gambar halamannya tetap persis sama, lapisan teks yang dikenali berada tidak terlihat di atasnya — hanya pencarian dan penyalinan yang menjadi mungkin.
Seberapa bagus pengenalan pada dokumen hasil pindaian yang buruk atau tulisan tangan? +
Pengenalan bekerja paling baik pada teks cetak yang bersih dan mudah dibaca. Pada catatan tulisan tangan atau hasil pindaian yang penuh noise, akurasinya menurun — beberapa karakter bisa salah dikenali atau hilang.
Bahasa apa saja yang dikenali? +
28 bahasa, semuanya beraksara Latin ditambah Yunani. Aksara non-Latin seperti Sirilik, Tionghoa, Arab, Ibrani, atau Thai sengaja tidak disertakan — tingkat keberhasilannya akan jauh lebih rendah di sana.
Seberapa akurat pengenalannya? +
Sangat baik pada hasil pindaian yang bersih dan lurus; jelas lebih buruk pada foto ponsel yang miring, cahaya buruk, atau tulisan tangan. Siapa pun yang memakai ulang teksnya sebaiknya memeriksanya kembali.
Apakah dokumen saya akan terlihat berbeda setelah pengenalan teks? +
Tidak. Teks yang dikenali muncul sebagai lapisan tidak terlihat di atas gambar — halamannya terlihat seperti sebelumnya, tapi kini bisa dicari.
Ini mungkin juga membantu
Kompres PDF
Perkecil ukuran PDF bergambar banyak secara signifikan — halaman akan diubah menjadi gambar.
Ubah PDF ke PDF/A
Ubah ke format PDF/A yang ramah arsip — untuk instansi dan penyimpanan jangka panjang.
Ubah PDF ke Word
Ekspor teks PDF sebagai file Word yang bisa diedit — tanpa unggah.
Edit Teks PDF
Klik teks yang ada di PDF dan ganti dengan teks baru.