 mousePDF
PDF-tekstgjenkjenning (OCR) — uten opplasting
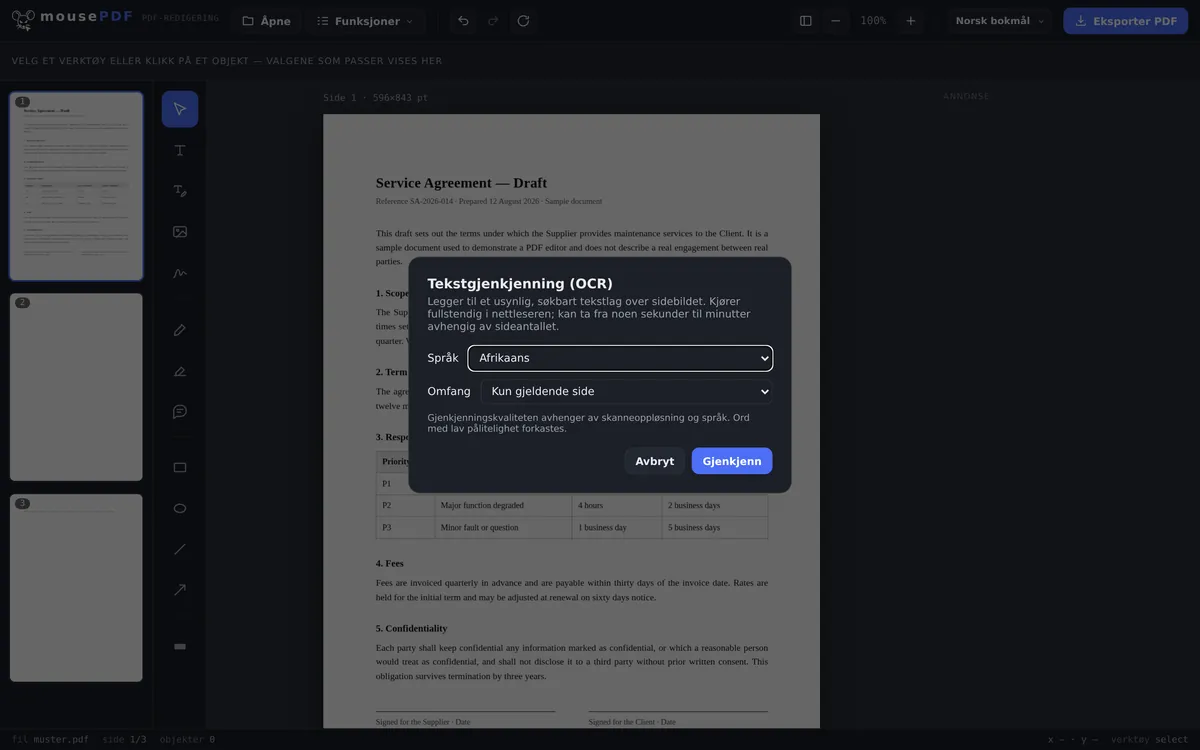
Legg et usynlig, søkbart tekstlag over skannede eller bildebaserte PDF-sider. Gjenkjenningen kjører helt i nettleseren din, filen din lastes aldri opp.
I tre trinn
Åpne PDF
Dra inn en skannet eller bildebasert PDF eller velg den.
Velg språk og omfang
Angi gjenkjenningsspråk og bestem om bare gjeldende side eller hele dokumentet skal gjenkjennes.
Eksporter
Lagre PDF med søkbart, usynlig tekstlag — sidebildet forblir visuelt uendret.
Typisk tilfelle: gjøre skannede dokumenter søkbare
Skannede kontrakter, fakturaer eller bøker inneholder ofte bare et sidebilde, ingen ekte tekst — man kan verken søke i dem eller kopiere tekst. mousePDF gjenkjenner teksten lokalt i nettleseren og legger den usynlig over bildet, slik at søk og kopiering fungerer uten at noe endres i utseendet til siden.
Tekstgjenkjenning i nettleseren — og hva som er spesielt med det
OCR er en av oppgavene der man ellers nesten uunngåelig laster opp noe: Gjenkjenningen trenger en språkmodell, og den ligger vanligvis på en server. Her kjører den i nettleseren din; det som lastes ned er kun modellen, aldri filen din.
Dette er spesielt viktig for de dokumentene man skanner: kontrakter, lønnsslipper, legebrev, kopier av ID-kort. En skanning er et bilde — og før den blir søkbar, må noe lese den. At dette noe kjører på din egen enhet i din egen nettleser, er den egentlige forskjellen.
28 språk er tilgjengelige for OCR. Modellen for det valgte språket lastes først ned ved selve kjøringen — siden forblir dermed lett, og du laster kun ned det du trenger.
Hvor gjenkjenningen når sine grenser
Ikke-latinske skriftsystemer mangler bevisst. Ingen kyrillisk, ingen kinesisk, japansk eller koreansk, ingen arabisk, hebraisk, devanagari eller thai. Modellene for dette er betydelig større og treffsikkerheten merkbart lavere — et resultat man må rette opp tegn for tegn hjelper ingen. Gresk er med, fordi det i denne sammenhengen ikke faller i samme klasse.
Gjenkjenningen er aldri feilfri. Den leser fra piksler det som en gang var tekst. En ren skanning med rett orientering gir svært gode resultater; et skjevt mobilfoto i dårlig lys, en kroket håndskrift eller en uvanlig dekorskrift gir merkbart dårligere resultater. Den som gjenbruker teksten, bør lese gjennom den — det gjelder for enhver OCR-behandlet versjon, ikke bare denne.
Utseendet til siden endres ikke. Den gjenkjente teksten legges som et usynlig lag over bildet: Du ser fortsatt skanningen din, men kan søke og markere i den. Gjenkjenningsfeil er derfor ikke synlige i bildet — de viser seg først når du kopierer ut tekst.
OCR er også nyttig etter komprimering av en PDF: Da blir sidene til bilder og mister tekstlaget sitt — tekstgjenkjenningen bygger det opp på nytt.
Ofte stilte spørsmål
Blir dokumentet mitt lastet opp for tekstgjenkjenningen? +
Nei. Gjenkjenningen kjører fullstendig i nettleseren via en lokalt lastet OCR-motor — filen forlater aldri enheten din.
Hvilke språk støttes? +
Et større utvalg europeiske språk med latinsk eller gresk skrift. Skriftsystemer som kinesisk, arabisk, kyrillisk eller devanagari støttes for øyeblikket ikke for OCR.
Hvor lang tid tar gjenkjenningen? +
Fra noen sekunder til noen få minutter, avhengig av antall sider og enhetens ytelse.
Endrer tekstgjenkjenningen utseendet til siden? +
Nei. Sidebildet forblir helt likt, det gjenkjente tekstlaget ligger usynlig over — bare søk og kopiering blir dermed mulig.
Hvor god er gjenkjenningen ved dårlig skannede eller håndskrevne dokumenter? +
Gjenkjenningen fungerer best på rent trykte, lett leselige tekster. Ved håndskrevne notater eller sterkt støyende skanninger synker nøyaktigheten — da kan enkelte tegn bli feil gjenkjent eller mangle.
Hvilke språk gjenkjennes? +
28, alle med latinsk skrift pluss gresk. Ikke-latinske skriftsystemer som kyrillisk, kinesisk, arabisk, hebraisk eller thai er bevisst ikke med — treffsikkerheten ville vært betydelig dårligere der.
Hvor nøyaktig er gjenkjenningen? +
Svært god ved en ren, rett skanning; merkbart dårligere ved skjeve mobilfoto, dårlig lys eller håndskrift. Den som gjenbruker teksten, bør lese gjennom den.
Ser dokumentet mitt annerledes ut etter tekstgjenkjenningen? +
Nei. Den gjenkjente teksten kommer som et usynlig lag over bildet — siden ser ut som før, men er søkbar.
Dette kan også hjelpe
Komprimere PDF
Gjøre bildetunge PDF-er betydelig mindre — sidene blir da til bilder.
Konvertere PDF til PDF/A
Konvertere til det arkivvennlige PDF/A-formatet — for myndigheter og langtidslagring.
Konvertere PDF til Word
Eksportere PDF-tekst som en redigerbar Word-fil — uten opplasting.
Redigere PDF-tekst
Klikke på eksisterende tekst i PDF-en og erstatte den med ny.