 mousePDF
PDF teksto atpažinimas (OCR) — be įkėlimo
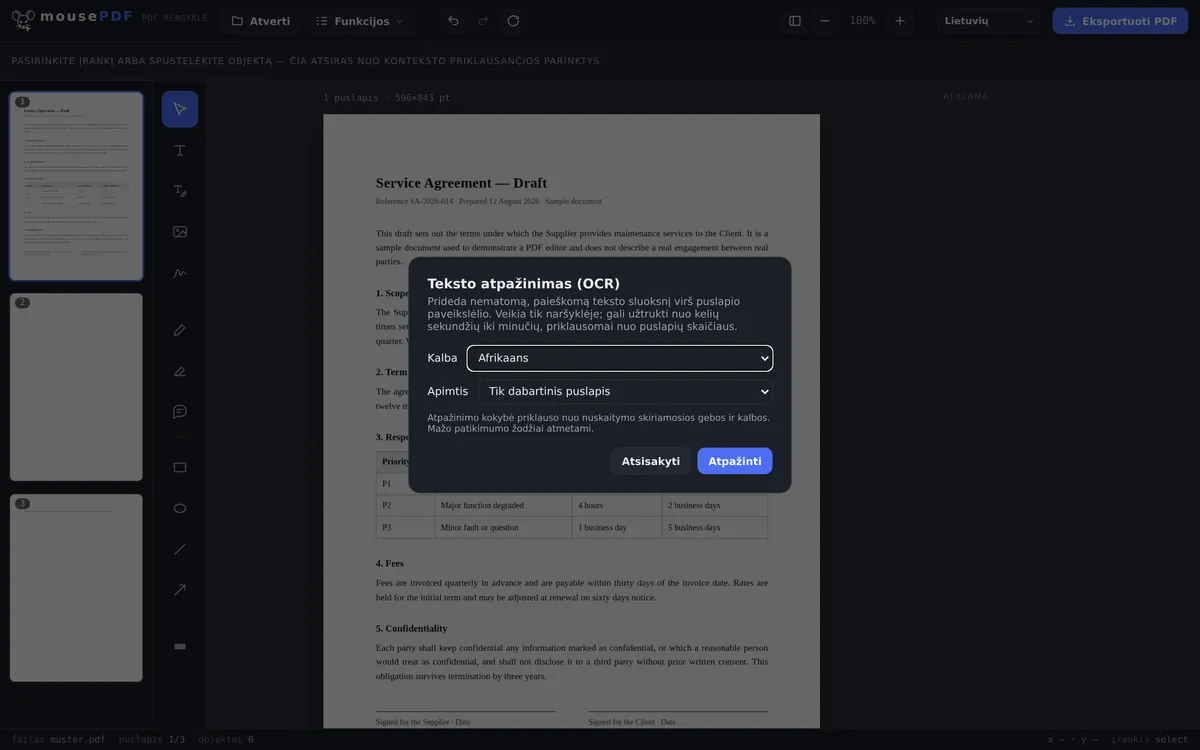
Uždėkite nematomą, ieškomą teksto sluoksnį ant nuskaitytų arba kaip paveikslėlis pateikiamų PDF puslapių. Atpažinimas vyksta visiškai jūsų naršyklėje, jūsų failas niekada neįkeliamas.
Trys žingsniai
Atidarykite PDF
Įtempkite nuskaitytą arba paveikslėliu pagrįstą PDF į langą arba pasirinkite iš įrenginio.
Pasirinkite kalbą ir apimtį
Nustatykite atpažinimo kalbą ir nuspręskite, ar atpažinti tik dabartinį puslapį, ar visą dokumentą.
Eksportuokite
Išsaugokite PDF su ieškomu, nematomu teksto sluoksniu — puslapio vaizdas išoriškai lieka nepakitęs.
Tipinis atvejis: nuskaitytų dokumentų padarymas ieškomais
Nuskaitytose sutartyse, sąskaitose ar knygose dažnai yra tik puslapio vaizdas, o ne tikras tekstas — juose negalima nei ieškoti, nei kopijuoti teksto. mousePDF atpažįsta tekstą vietoje naršyklėje ir uždeda jį nematomai ant vaizdo, kad paieška ir kopijavimas veiktų, o puslapio išvaizda nepasikeistų.
Teksto atpažinimas naršyklėje — ir kas čia ypatinga
OCR yra viena iš tų užduočių, kurioms atlikti kitu atveju beveik neišvengiamai reikia ką nors įkelti: atpažinimui reikalingas kalbos modelis, kuris paprastai laikomas serveryje. Čia jis veikia jūsų naršyklėje; įkeliamas tik modelis, o ne jūsų failas.
Tai ypač svarbu su dokumentais, kuriuos nuskaitote: sutartimis, atlyginimo lapeliais, gydytojų pažymomis, asmens dokumentų kopijomis. Nuskaitytas vaizdas yra paveikslėlis — ir prieš tampant ieškomu, jį kažkas turi perskaityti. Tai, kad šis „kažkas“ veikia jūsų pačių įrenginyje, jūsų naršyklėje, ir yra tikrasis skirtumas.
OCR yra prieinamos 28 kalbos. Pasirinktos kalbos modelis įkeliamas tik paleidus atpažinimą — todėl puslapis lieka lengvas, ir jūs įkeliate tik tai, ko reikia.
Kur atpažinimas pasiekia savo ribas
Ne lotyniškų raštų sąmoningai nėra. Nei kirilicos, nei kinų, japonų ar korėjiečių, nei arabų, hebrajų, devanagari ar tajų raštų. Tam skirti modeliai yra gerokai didesni, o atpažinimo tikslumas pastebimai žemesnis — rezultatas, kurį reikia taisyti simbolis po simbolio, niekam nepadeda. Graikų kalba yra įtraukta, nes šiuo požiūriu ji nepatenka į tą pačią kategoriją.
Atpažinimas niekada nėra be klaidų. Jis iš pikselių atkuria tai, kas kadaise buvo tekstas. Švarus, tiesiai orientuotas nuskaitymas duoda labai gerus rezultatus; kreiva telefono nuotrauka blogame apšvietime, neaiškus ranka rašytas tekstas ar neįprastas dekoratyvinis šriftas — gerokai prastesnius. Kas naudos tekstą toliau, turėtų jį perskaityti ir patikrinti — tai galioja kiekvienai OCR apdorotai versijai, ne tik šiai.
Puslapio išvaizda nesikeičia. Atpažintas tekstas uždedamas kaip nematomas sluoksnis ant vaizdo: jūs vis dar matote savo nuskaitytą vaizdą, bet galite jame ieškoti ir žymėti. Todėl atpažinimo klaidos vaizde nematomos — jos paaiškėja tik iškopijavus tekstą.
OCR naudinga ir po PDF suspaudimo: tuomet puslapiai virsta paveikslėliais ir netenka teksto sluoksnio — teksto atpažinimas jį sukuria iš naujo.
Dažniausiai užduodami klausimai
Ar mano dokumentas įkeliamas teksto atpažinimui? +
Ne. Atpažinimas vyksta visiškai naršyklėje, naudojant vietoje įkeltą OCR variklį — failas niekada nepalieka jūsų įrenginio.
Kokios kalbos palaikomos? +
Didelis pasirinkimas Europos kalbų su lotynišku arba graikišku raštu. Tokie raštai kaip kinų, arabų, kirilica ar devanagari šiuo metu OCR nepalaikomi.
Kiek laiko trunka atpažinimas? +
Priklausomai nuo puslapių skaičiaus ir įrenginio našumo — nuo kelių sekundžių iki kelių minučių.
Ar teksto atpažinimas pakeičia puslapio išvaizdą? +
Ne. Puslapio vaizdas lieka lygiai toks pat, atpažintas teksto sluoksnis guli nematomai virš jo — tai tik leidžia ieškoti ir kopijuoti.
Koks atpažinimo tikslumas su blogai nuskaitytais ar ranka rašytais dokumentais? +
Atpažinimas geriausiai veikia su švariai atspausdintu, gerai įskaitomu tekstu. Su ranka rašytomis pastabomis ar stipriai triukšmingais nuskaitymais tikslumas mažėja — tuomet pavieniai simboliai gali būti atpažinti klaidingai arba jų gali trūkti.
Kokios kalbos atpažįstamos? +
28 — visos su lotynišku raštu, plius graikų kalba. Ne lotyniški raštai, tokie kaip kirilica, kinų, arabų, hebrajų ar tajų, sąmoningai neįtraukti — tikslumas ten būtų gerokai prastesnis.
Koks atpažinimo tikslumas? +
Su švariu, tiesiai nuskaitytu vaizdu — labai geras; su kreivomis telefono nuotraukomis, blogu apšvietimu ar ranka rašytu tekstu — pastebimai prastesnis. Kas naudos tekstą toliau, turėtų jį perskaityti ir patikrinti.
Ar mano dokumentas po teksto atpažinimo atrodo kitaip? +
Ne. Atpažintas tekstas uždedamas kaip nematomas sluoksnis ant vaizdo — puslapis atrodo taip pat, kaip anksčiau, bet tampa ieškomas.
Tai taip pat gali būti naudinga
PDF suspaudimas
Gerokai sumažinkite daug paveikslėlių turinčius PDF failus — puslapiai virsta paveikslėliais.
PDF konvertavimas į PDF/A
Konvertuokite į archyvavimui pritaikytą PDF/A formatą — institucijoms ir ilgalaikiam saugojimui.
PDF konvertavimas į Word
Eksportuokite PDF tekstą kaip redaguojamą Word failą — be įkėlimo.
PDF teksto redagavimas
Spustelėkite esamą tekstą PDF faile ir pakeiskite jį nauju.