 mousePDF
PDF teksta atpazīšana (OCR) — bez augšupielādes
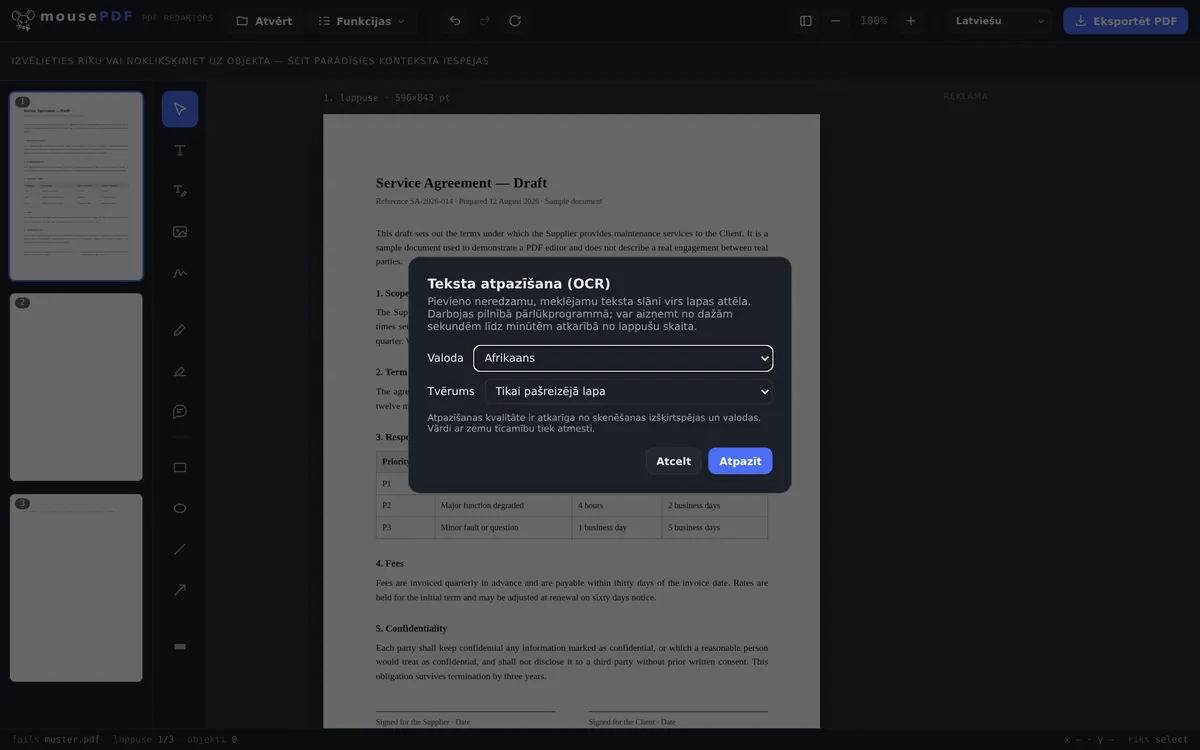
Uzlieciet neredzamu, meklējamu teksta slāni virs ieskenētām vai kā attēls pieejamām PDF lapām. Atpazīšana notiek pilnībā jūsu pārlūkā, jūsu fails nekad netiek augšupielādēts.
Trīs soļos
Atveriet PDF
Ievelciet ieskenētu vai uz attēla balstītu PDF failu logā vai izvēlieties to.
Izvēlieties valodu un apjomu
Iestatiet atpazīšanas valodu un izlemiet, vai jāatpazīst tikai pašreizējā lapa vai viss dokuments.
Eksportējiet
Saglabājiet PDF ar meklējamu, neredzamu teksta slāni — lapas attēls vizuāli paliek nemainīgs.
Tipisks gadījums: padarīt ieskenētus dokumentus meklējamus
Ieskenēti līgumi, rēķini vai grāmatas bieži satur tikai lapas attēlu, nevis īstu tekstu — tajos nevar ne meklēt, ne kopēt tekstu. mousePDF atpazīst tekstu vietēji pārlūkā un neredzami novieto to virs attēla, lai meklēšana un kopēšana darbotos, nemainot lapas izskatu.
Teksta atpazīšana pārlūkā — un kas tajā ir īpašs
OCR pieder pie uzdevumiem, kuriem citādi gandrīz neizbēgami kaut kas jāaugšupielādē: atpazīšanai vajadzīgs valodas modelis, un tas parasti atrodas serverī. Šeit tas darbojas jūsu pārlūkā; tiek ielādēts tikai modelis, nekad jūsu fails.
Tas ir īpaši svarīgi tieši tiem dokumentiem, ko parasti ieskenē: līgumiem, algas lapām, ārsta izziņām, personu apliecinošu dokumentu kopijām. Skenējums ir attēls — un pirms tas kļūst meklējams, kaut kam tas jāizlasa. Ka tas notiek jūsu pašu ierīcē, jūsu pārlūkā, ir īstā atšķirība.
OCR pieejamas 28 valodas. Izvēlētās valodas modelis tiek lejupielādēts tikai faktiskās darbības laikā — tādēļ lapa paliek viegla, un jūs lejupielādējat tikai to, kas nepieciešams.
Kur atpazīšanai ir robežas
Ne-latīņu raksta sistēmas apzināti trūkst. Nav kirilicas, ķīniešu, japāņu vai korejiešu, nav arābu, ebreju, devanāgari vai taju valodas. Šo valodu modeļi ir ievērojami lielāki, un precizitāte manāmi zemāka — rezultāts, kas jālabo rakstzīme pa rakstzīmei, nevienam nepalīdz. Grieķu valoda ir iekļauta, jo šajā ziņā tā neietilpst tajā pašā klasē.
Atpazīšana nekad nav bez kļūdām. Tā no pikseļiem izlasa atpakaļ to, kas reiz bija teksts. Tīrs skenējums ar taisnu orientāciju sniedz ļoti labus rezultātus; sašķiebts telefona foto sliktā apgaismojumā, nelīdzens rokraksts vai neparasts dekoratīvs šrifts — manāmi sliktākus. Kas tekstu izmanto tālāk, tam vajadzētu to pārbaudīt — tas attiecas uz jebkuru OCR apstrādātu versiju, ne tikai šo.
Lapas izskats nemainās. Atpazītais teksts tiek novietots kā neredzams slānis virs attēla: jūs joprojām redzat savu skenējumu, bet tajā varat meklēt un iezīmēt. Tāpēc atpazīšanas kļūdas attēlā nav redzamas — tās parādās tikai, kad izkopējat tekstu.
OCR noderīga arī pēc PDF saspiešanas: tad lapas kļūst par attēliem un zaudē savu teksta slāni — teksta atpazīšana to izveido no jauna.
Biežāk uzdotie jautājumi
Vai mans dokuments teksta atpazīšanai tiek augšupielādēts? +
Nē. Atpazīšana notiek pilnībā pārlūkā, izmantojot vietēji ielādētu OCR dzinēju — fails nekad nepamet jūsu ierīci.
Kuras valodas tiek atbalstītas? +
Plaša Eiropas valodu izvēle ar latīņu vai grieķu rakstu. Rakstu sistēmas, piemēram, ķīniešu, arābu, kirilica vai devanāgari, pašlaik OCR netiek atbalstītas.
Cik ilgi ilgst atpazīšana? +
Atkarībā no lapu skaita un ierīces veiktspējas — no dažām sekundēm līdz dažām minūtēm.
Vai teksta atpazīšana maina lapas izskatu? +
Nē. Lapas attēls paliek tieši tāds pats, atpazītais teksta slānis atrodas neredzami virs tā — tas padara iespējamu tikai meklēšanu un kopēšanu.
Cik laba ir atpazīšana slikti ieskenētiem vai rokrakstā rakstītiem dokumentiem? +
Atpazīšana darbojas vislabāk ar skaidri iespiestiem, labi salasāmiem tekstiem. Rokrakstā rakstītām piezīmēm vai stipri trokšņainiem skenējumiem precizitāte samazinās — tad atsevišķas rakstzīmes var tikt atpazītas nepareizi vai iztrūkt.
Kuras valodas tiek atpazītas? +
28, visas ar latīņu rakstu plus grieķu valoda. Ne-latīņu rakstu sistēmas, piemēram, kirilica, ķīniešu, arābu, ebreju vai taju valoda, apzināti nav iekļautas — tur precizitāte būtu manāmi sliktāka.
Cik precīza ir atpazīšana? +
Tīram, taisnam skenējumam — ļoti laba; sašķiebtiem telefona foto, sliktam apgaismojumam vai rokrakstam — manāmi sliktāka. Kas tekstu izmanto tālāk, tam vajadzētu to pārbaudīt.
Vai mans dokuments pēc teksta atpazīšanas izskatās citādi? +
Nē. Atpazītais teksts tiek novietots kā neredzams slānis virs attēla — lapa izskatās tāda pati kā iepriekš, bet ir meklējama.
Tas arī varētu palīdzēt
PDF saspiešana
Ievērojami samaziniet daudz attēlu saturošus PDF failus — lapas tiek pārvērstas attēlos.
PDF konvertēšana PDF/A formātā
Konvertējiet arhīvam draudzīgā PDF/A formātā — iestādēm un ilgtermiņa glabāšanai.
PDF konvertēšana Word formātā
Eksportējiet PDF tekstu kā rediģējamu Word failu — bez augšupielādes.
PDF teksta rediģēšana
Noklikšķiniet esošu PDF tekstu un aizstājiet to ar jaunu.