 mousePDF
PDF metin tanıma (OCR) — yüklemeden
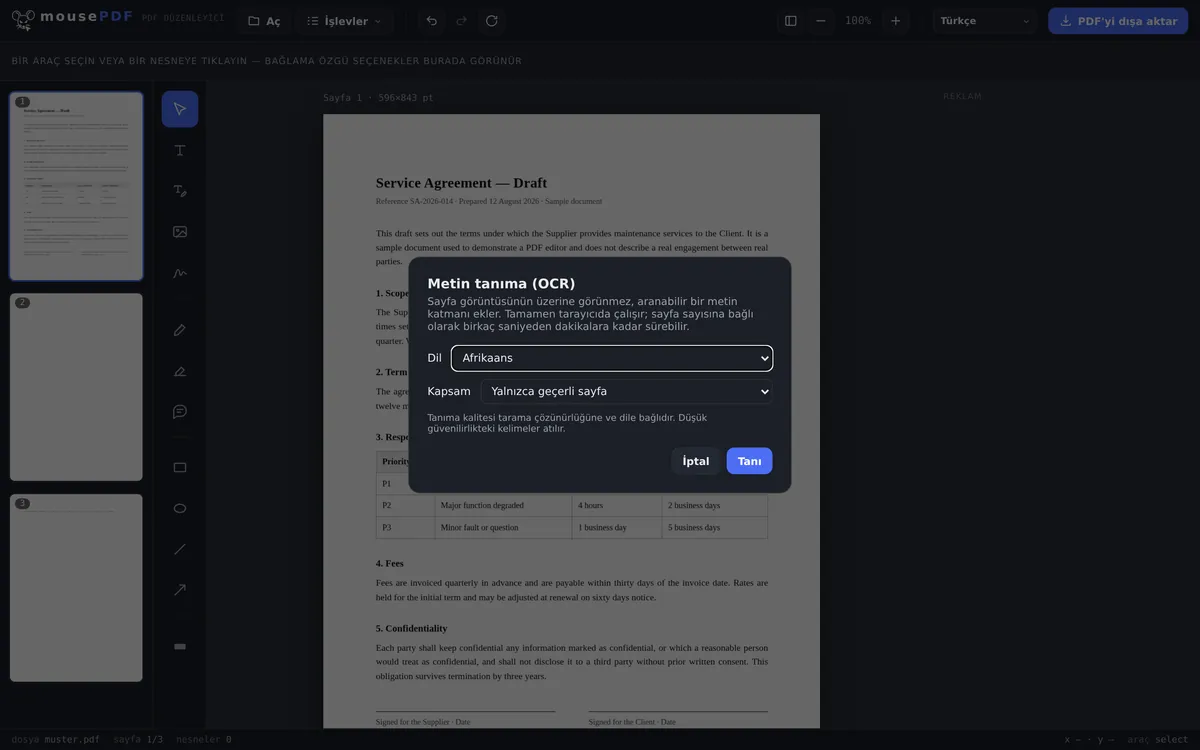
Taranmış veya resim olarak mevcut PDF sayfalarının üzerine görünmez, aranabilir bir metin katmanı yerleştirin. Tanıma tamamen tarayıcınızda gerçekleşir, dosyanız asla yüklenmez.
Üç adımda
PDF'yi aç
Taranmış veya resim tabanlı PDF'yi sürükleyip pencereye bırakın veya seçin.
Dil ve kapsam seçin
Tanıma dilini belirleyin ve yalnızca mevcut sayfanın mı yoksa tüm belgenin mi tanınacağına karar verin.
Dışa aktar
Aranabilir, görünmez bir metin katmanı içeren PDF'yi kaydedin — sayfa resmi görsel olarak değişmeden kalır.
Tipik durum: taranmış belgeleri aranabilir hale getirmek
Taranmış sözleşmeler, faturalar veya kitaplar genellikle yalnızca bir sayfa resmi içerir, gerçek metin içermez — içinde ne arama yapabilir ne de metin kopyalayabilirsiniz. mousePDF metni tarayıcıda yerel olarak tanır ve görünmez şekilde resmin üzerine yerleştirir, böylece arama ve kopyalama çalışır, sayfanın görünümünde hiçbir şey değişmez.
Tarayıcıda metin tanıma — ve bunda özel olan ne
OCR, genellikle neredeyse kaçınılmaz olarak bir şeylerin yüklendiği görevlerden biridir: tanıma bir dil modeline ihtiyaç duyar, ve bu genellikle bir sunucudadır. Burada tarayıcınızda çalışır; yalnızca model yüklenir, dosyanız asla yüklenmez.
Bu, tam olarak taradığınız belgelerde önemlidir: sözleşmeler, maaş bordroları, doktor mektupları, kimlik kopyaları. Bir tarama bir resimdir — ve aranabilir hale gelmeden önce, bir şeyin onu okuması gerekir. Bu bir şeyin kendi cihazınızda, tarayıcınızda çalışması, asıl farktır.
OCR için 28 dil mevcuttur. Seçilen dilin modeli yalnızca gerçek çalıştırma sırasında yüklenir — bu sayede sayfa hafif kalır ve yalnızca ihtiyacınız olanı yüklersiniz.
Tanımanın sınırları nerede
Latin olmayan yazı sistemleri bilinçli olarak eksik. Kiril yok, Çince, Japonca veya Korece yok, Arapça, İbranice, Devanagari veya Tayca yok. Bunlar için modeller önemli ölçüde daha büyük ve doğruluk oranı belirgin şekilde daha düşük — karakter karakter düzeltilmesi gereken bir sonuç kimseye yardımcı olmaz. Yunanca dahildir, çünkü bu açıdan aynı kategoriye girmez.
Tanıma asla hatasız değildir. Piksellerden bir zamanlar metin olan şeyi geri okur. Düz yönlendirmeli temiz bir tarama çok iyi sonuçlar verir; kötü ışıkta çekilmiş eğri bir telefon fotoğrafı, karışık bir el yazısı veya alışılmadık bir süslü yazı tipi belirgin şekilde daha kötü sonuçlar verir. Metni yeniden kullanan, onu kontrol etmelidir — bu, sadece bunun için değil, her OCR işlenmiş sürüm için geçerlidir.
Sayfanın görünümü değişmez. Tanınan metin, resmin üzerine görünmez bir katman olarak yerleştirilir: taramanızı görmeye devam edersiniz, ancak içinde arama yapabilir ve işaretleyebilirsiniz. Tanıma hataları bu yüzden resimde görünmez — yalnızca metni kopyaladığınızda ortaya çıkar.
OCR, bir PDF'yi sıkıştırdıktan sonra da kullanışlıdır: bu sırada sayfalar resim haline gelir ve metin katmanlarını kaybeder — metin tanıma bunu yeniden oluşturur.
Sıkça sorulan sorular
Metin tanıma için belgem yükleniyor mu? +
Hayır. Tanıma tamamen tarayıcıda, yerel olarak yüklenen bir OCR motoru üzerinden çalışır — dosya asla cihazınızdan çıkmaz.
Hangi diller destekleniyor? +
Latin veya Yunan yazısına sahip daha geniş bir Avrupa dili seçkisi. Çince, Arapça, Kiril veya Devanagari gibi yazı sistemleri şu anda OCR için desteklenmiyor.
Tanıma ne kadar sürer? +
Sayfa sayısına ve cihaz performansına bağlı olarak birkaç saniyeden birkaç dakikaya kadar.
Metin tanıma sayfanın görünümünü değiştirir mi? +
Hayır. Sayfa resmi tam olarak aynı kalır, tanınan metin katmanı üzerinde görünmez şekilde durur — yalnızca arama ve kopyalama bu sayede mümkün olur.
Kötü taranmış veya el yazısı belgelerde tanıma ne kadar iyi? +
Tanıma, temiz basılmış, iyi okunabilir metinlerde en iyi şekilde çalışır. El yazısı notlarda veya çok gürültülü taramalarda doğruluk düşer — o zaman bazı karakterler yanlış tanınabilir veya eksik olabilir.
Hangi diller tanınıyor? +
28 dil, hepsi Latin yazısıyla artı Yunanca. Kiril, Çince, Arapça, İbranice veya Tayca gibi Latin olmayan yazı sistemleri bilinçli olarak dahil değil — doğruluk oranı orada belirgin şekilde daha kötü olurdu.
Tanıma ne kadar hassas? +
Temiz, düz bir taramada çok iyi; eğri telefon fotoğraflarında, kötü ışıkta veya el yazısında belirgin şekilde daha kötü. Metni yeniden kullanan, onu kontrol etmelidir.
Belgem metin tanımadan sonra farklı mı görünüyor? +
Hayır. Tanınan metin, resmin üzerine görünmez bir katman olarak gelir — sayfa öncekiyle aynı görünür, ama aranabilir hale gelir.
Bunlar da yardımcı olabilir
PDF sıkıştır
Resim ağırlıklı PDF'leri önemli ölçüde küçültün — sayfalar bu sırada resim haline gelir.
PDF'yi PDF/A'ya dönüştür
Arşive uygun PDF/A formatına dönüştürün — kurumlar ve uzun süreli saklama için.
PDF'yi Word'e dönüştür
PDF metnini düzenlenebilir bir Word dosyası olarak dışa aktarın — yüklemeden.
PDF metnini düzenle
PDF'deki mevcut metne tıklayın ve yenisiyle değiştirin.