 mousePDF
PDFテキスト認識(OCR)——アップロード不要
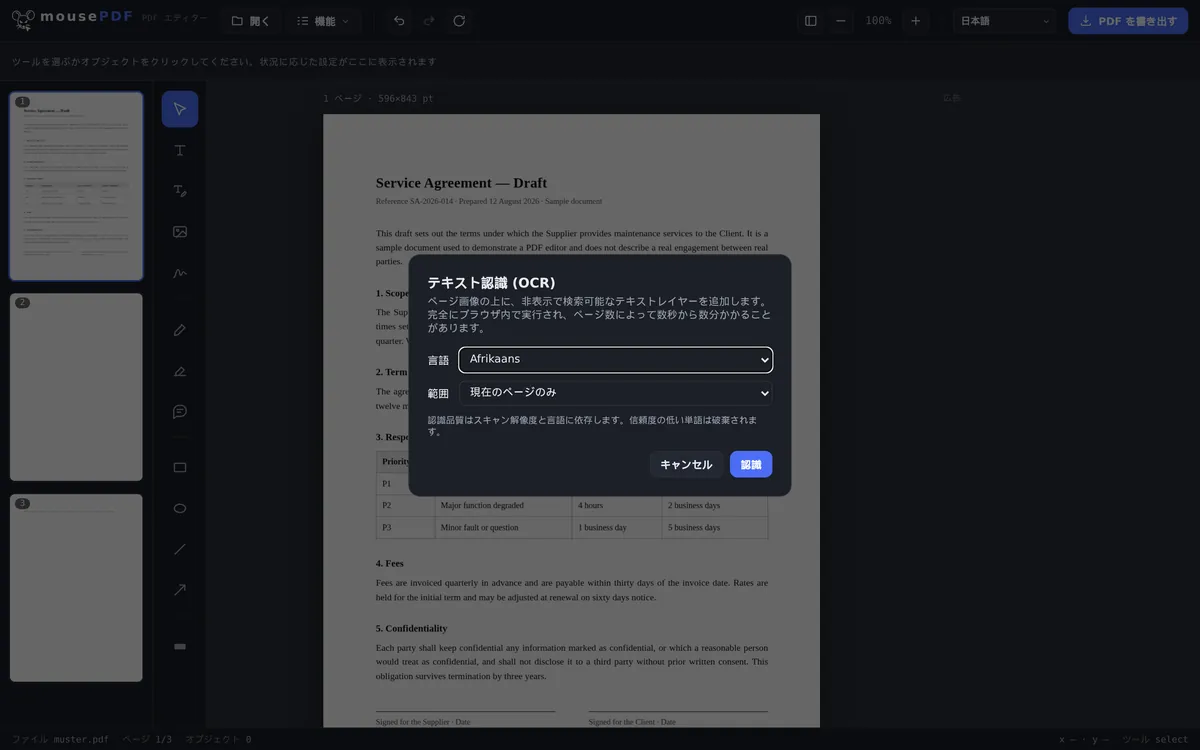
スキャンされた、または画像として存在するPDFページの上に、見えない検索可能なテキスト層を重ねます。認識処理はすべてあなたのブラウザ内で完結し、ファイルがアップロードされることは一切ありません。
3ステップで完了
PDFを開く
スキャンした、または画像ベースのPDFをウィンドウにドラッグ&ドロップするか、選択して読み込みます。
言語と範囲を選択
認識言語を設定し、現在のページのみを対象とするか、文書全体を対象とするかを選びます。
エクスポート
検索可能で見えないテキスト層を持つPDFを保存——ページの見た目は変わりません。
典型的なケース:スキャンした文書を検索可能にする
スキャンした契約書、請求書、書籍などには、多くの場合ページ画像しかなく、本物のテキストが含まれていません——検索もテキストのコピーもできません。mousePDFはブラウザ内でローカルにテキストを認識し、それを画像の上に見えない形で重ねます。これにより、ページの見た目を一切変えることなく、検索やコピーができるようになります。
ブラウザ内でのテキスト認識——その特別な点
OCRは、通常はほぼ必ず何かをアップロードしなければならない処理の一つです:認識には言語モデルが必要で、それは通常サーバー上に置かれています。ここではそれがあなたのブラウザ内で動作します。読み込まれるのはモデルだけで、あなたのファイルが読み込まれることは一切ありません。
これはまさに、スキャンするような文書にとって重要なことです:契約書、給与明細、診断書、身分証明書のコピーなど。スキャンとは画像であり、検索可能になる前には何かがそれを読み取る必要があります。その「何か」があなた自身の端末、あなたのブラウザ内で動作していることこそが、本当の違いです。
OCRでは28言語が利用可能です。選択した言語のモデルは、実際に実行するときにはじめて読み込まれます——これによりページ自体は軽量に保たれ、必要なものだけを読み込むことになります。
認識機能の限界
非ラテン文字は意図的に対象外としています。キリル文字、中国語、日本語、韓国語、アラビア語、ヘブライ語、デーヴァナーガリー文字、タイ語には対応していません。これらの文字用のモデルはかなり大きく、認識精度も明らかに低くなります——一文字ずつ手直ししなければならない結果は、誰の役にも立ちません。ギリシャ語は、この点で同じカテゴリーには当てはまらないため含まれています。
認識には常に誤りが含まれる可能性があります。ピクセルからかつてのテキストを読み取っているためです。きれいに正しい向きでスキャンされたものは非常に良い結果になりますが、暗い場所で撮影して傾いたスマートフォンの写真、乱雑な手書き文字、珍しい装飾フォントなどでは、明らかに結果が悪くなります。テキストをそのまま使う場合は、必ず見直しをしてください——これは、このツールに限らず、OCR処理を行ったすべてのバージョンに当てはまることです。
ページの見た目は変わりません。認識されたテキストは、見えない層として画像の上に重ねられます:あなたが目にするのは引き続きスキャン画像ですが、その中で検索やハイライトができるようになります。そのため、認識エラーは画像上には表示されません——それが表面化するのは、テキストをコピーしたときだけです。
PDFの圧縮後にもOCRは役立ちます:圧縮によってページが画像になり、テキスト層が失われますが、テキスト認識によってそれを新たに作り直せます。
よくある質問
テキスト認識のために私の文書はアップロードされますか? +
いいえ。認識処理はすべて、ローカルに読み込まれたOCRエンジンによってブラウザ内で行われます——ファイルがあなたの端末から出ていくことは一切ありません。
どの言語に対応していますか? +
ラテン文字またはギリシャ文字を使用する、幅広いヨーロッパ言語に対応しています。中国語、アラビア語、キリル文字、デーヴァナーガリー文字などの文字は、現時点ではOCRに対応していません。
認識にはどのくらい時間がかかりますか? +
ページ数や端末の性能により、数秒から数分程度かかります。
テキスト認識によってページの見た目は変わりますか? +
いいえ。ページ画像はまったく同じままで、認識されたテキスト層はその上に見えない形で重なります——これにより検索とコピーが可能になるだけです。
スキャン品質が悪い文書や手書きの文書では、認識精度はどうですか? +
認識機能は、きれいに印刷された読みやすいテキストで最もよく機能します。手書きのメモやノイズの多いスキャンでは精度が下がります——その場合、一部の文字が誤認識されたり、認識されなかったりすることがあります。
どの言語が認識対象ですか? +
ラテン文字を使用する言語28種類に加え、ギリシャ語です。キリル文字、中国語、アラビア語、ヘブライ語、タイ語などの非ラテン文字は意図的に含まれていません——これらの文字では認識精度が明らかに低くなるためです。
認識精度はどのくらいですか? +
きれいで正しい向きのスキャンでは非常に高精度です。傾いたスマートフォン写真、暗い場所での撮影、手書き文字では明らかに精度が下がります。テキストをそのまま使う場合は、必ず見直しをしてください。
テキスト認識後、私の文書の見た目は変わりますか? +
いいえ。認識されたテキストは、見えない層として画像の上に重なります——ページの見た目は以前と同じですが、検索可能になります。
こちらも役立つかもしれません
PDFを圧縮
画像の多いPDFを大幅に縮小——ページは画像になります。
PDFをPDF/Aに変換
アーカイブに適したPDF/A形式に変換——官公庁や長期保存に。
PDFをWordに変換
PDFテキストを編集可能なWordファイルとしてエクスポート——アップロード不要。
PDFテキストの編集
PDF内の既存テキストをクリックして、新しい内容に置き換えます。