 mousePDF
Recunoaștere de text PDF (OCR) — fără încărcare
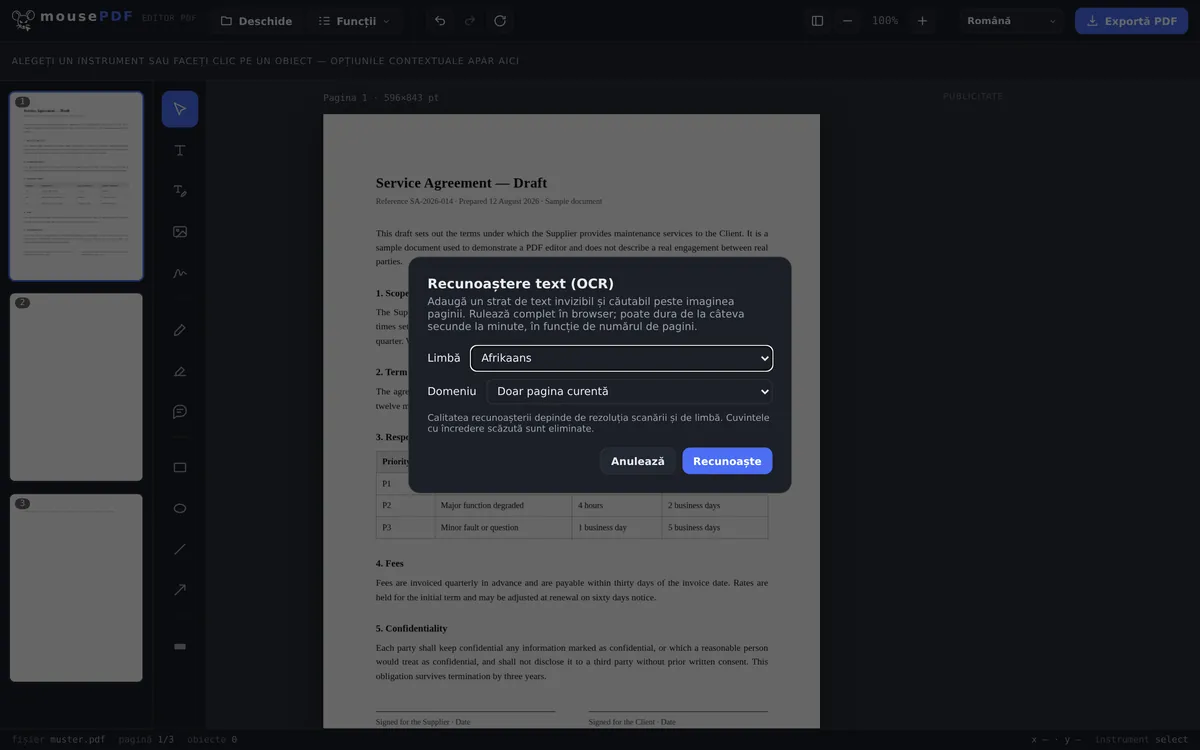
Adaugă un strat de text invizibil, căutabil, peste paginile PDF scanate sau existente ca imagine. Recunoașterea rulează complet în browserul tău, fișierul tău nu este niciodată încărcat.
În trei pași
Deschide PDF-ul
Trage PDF-ul scanat sau bazat pe imagine în fereastră prin drag-and-drop sau selectează-l.
Alege limba și domeniul
Stabilește limba de recunoaștere și decide dacă este recunoscută doar pagina curentă sau întregul document.
Exportă
Salvează PDF-ul cu un strat de text căutabil, invizibil — imaginea paginii rămâne vizual neschimbată.
Caz tipic: fă căutabile documentele scanate
Contractele, facturile sau cărțile scanate conțin adesea doar o imagine a paginii, niciun text real — nu poți căuta în ele și nici copia text. mousePDF recunoaște textul local, în browser, și îl așază invizibil peste imagine, astfel încât căutarea și copierea funcționează, fără să se schimbe ceva la aspectul paginii.
Recunoașterea de text în browser — și ce este special la asta
OCR face parte din sarcinile pentru care altfel aproape întotdeauna trebuie să încarci ceva: recunoașterea are nevoie de un model lingvistic, iar acesta se află de obicei pe un server. Aici rulează în browserul tău; se încarcă doar modelul, niciodată fișierul tău.
Asta contează exact la documentele pe care le scanezi: contracte, fluturași de salariu, scrisori medicale, copii de acte de identitate. O scanare este o imagine — și înainte să devină căutabilă, ceva trebuie s-o citească. Faptul că acel ceva rulează pe propriul tău dispozitiv, în propriul tău browser, este diferența reală.
28 de limbi sunt disponibile pentru OCR. Modelul limbii alese este încărcat abia la rularea efectivă — pagina rămâne astfel ușoară, iar tu încarci doar ce ai nevoie.
Unde recunoașterea își atinge limitele
Scrierile non-latine lipsesc în mod deliberat. Niciun chirilic, niciun chinez, japonez sau coreean, niciun arab, ebraic, devanagari sau thailandez. Modelele pentru acestea sunt semnificativ mai mari, iar rata de succes vizibil mai mică — un rezultat pe care trebuie să-l corectezi caracter cu caracter nu ajută pe nimeni. Greaca este inclusă, pentru că nu se încadrează în aceeași categorie din acest punct de vedere.
Recunoașterea nu este niciodată perfectă. Ea citește din pixeli ceea ce a fost cândva text. O scanare curată, dreaptă, dă rezultate foarte bune; o fotografie strâmbă de telefon, în lumină proastă, un scris de mână mâzgălit sau un font decorativ neobișnuit dau rezultate vizibil mai slabe. Cine reutilizează textul ar trebui să-l recitească — asta este valabil pentru orice versiune procesată prin OCR, nu doar pentru aceasta.
Aspectul paginii nu se schimbă. Textul recunoscut este așezat ca strat invizibil peste imagine: tu continui să vezi scanarea ta, dar poți căuta și marca în ea. Erorile de recunoaștere nu sunt așadar vizibile în imagine — apar abia când extragi textul prin copiere.
OCR este util și după comprimarea unui PDF: la comprimare paginile devin imagini și își pierd stratul de text — recunoașterea de text îl reconstituie.
Întrebări frecvente
Este documentul meu încărcat pentru recunoașterea de text? +
Nu. Recunoașterea rulează complet în browser printr-un motor OCR încărcat local — fișierul nu-ți părăsește niciodată dispozitivul.
Ce limbi sunt acceptate? +
O selecție mai mare de limbi europene cu scriere latină sau greacă. Scrieri precum chineza, araba, chirilica sau devanagari nu sunt acceptate în prezent pentru OCR.
Cât durează recunoașterea? +
În funcție de numărul de pagini și de performanța dispozitivului, de la câteva secunde până la câteva minute.
Schimbă recunoașterea de text aspectul paginii? +
Nu. Imaginea paginii rămâne exact la fel, stratul de text recunoscut se așază invizibil peste ea — doar căutarea și copierea devin posibile astfel.
Cât de bună este recunoașterea la documente scanate prost sau scrise de mână? +
Recunoașterea funcționează cel mai bine la texte tipărite curat, ușor de citit. La notițe scrise de mână sau scanări foarte zgomotoase, precizia scade — atunci caractere individuale pot fi recunoscute greșit sau pot lipsi.
Ce limbi sunt recunoscute? +
28, toate cu scriere latină, plus greaca. Scrierile non-latine precum chirilica, chineza, araba, ebraica sau thailandeza nu sunt incluse în mod deliberat — rata de succes ar fi acolo semnificativ mai slabă.
Cât de precisă este recunoașterea? +
La o scanare curată și dreaptă, foarte bună; la fotografii strâmbe de telefon, lumină proastă sau scris de mână, vizibil mai slabă. Cine reutilizează textul ar trebui să-l recitească.
Arată documentul meu diferit după recunoașterea de text? +
Nu. Textul recunoscut vine ca strat invizibil peste imagine — pagina arată ca înainte, dar este căutabilă.
Te-ar mai putea ajuta
Comprimă PDF
Micșorează semnificativ PDF-urile cu multe imagini — paginile devin astfel imagini.
Convertește PDF în PDF/A
Convertește în formatul PDF/A prietenos pentru arhivare — pentru instituții și păstrare pe termen lung.
Convertește PDF în Word
Exportă textul PDF ca fișier Word editabil — fără încărcare.
Editează text PDF
Dă clic pe textul existent din PDF și înlocuiește-l cu unul nou.