 mousePDF
PDF-szövegfelismerés (OCR) — feltöltés nélkül
Helyezz egy láthatatlan, kereshető szövegréteget a beszkennelt vagy képként megjelenő PDF-oldalak fölé. A felismerés teljes egészében a böngésződben fut, a fájlod soha nem kerül feltöltésre.
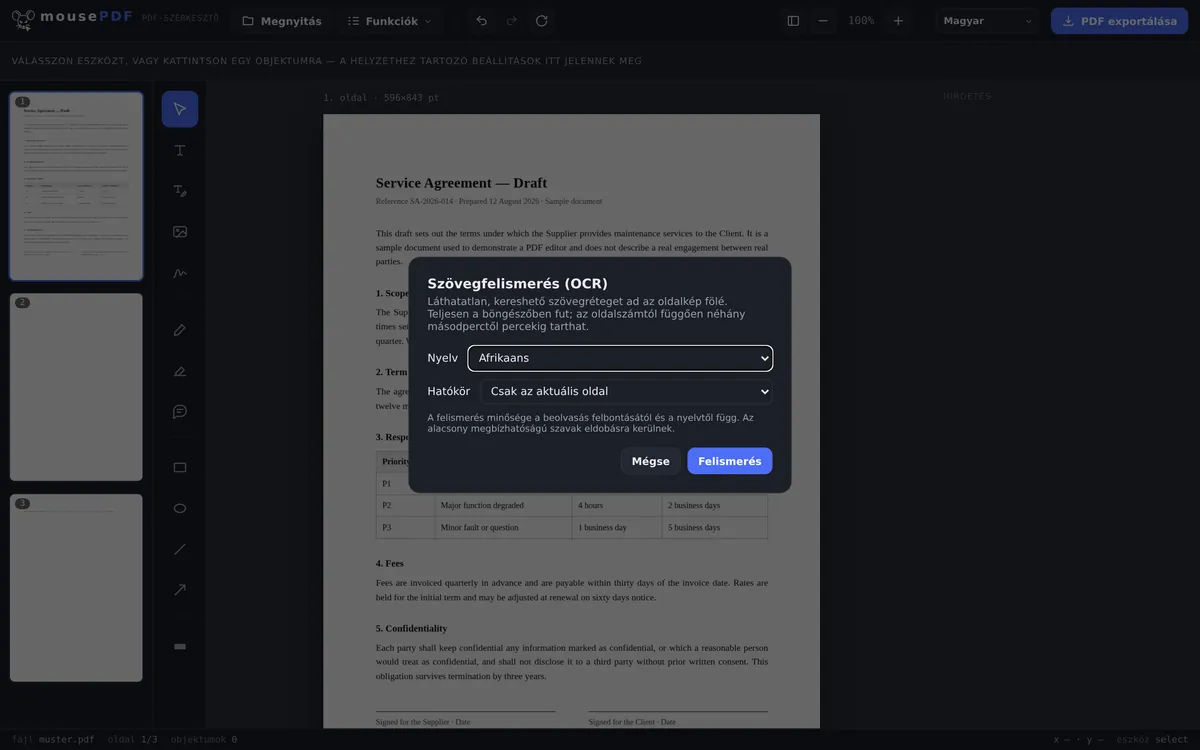
Három lépésben
PDF megnyitása
Húzd be a beszkennelt vagy képalapú PDF-et az ablakba, vagy válaszd ki.
Nyelv és terjedelem kiválasztása
Add meg a felismerési nyelvet, és döntsd el, hogy csak az aktuális oldalt vagy az egész dokumentumot ismerje-e fel.
Exportálás
Mentsd a PDF-et kereshető, láthatatlan szövegréteggel — az oldal képe vizuálisan változatlan marad.
Tipikus eset: beszkennelt dokumentumok kereshetővé tétele
A beszkennelt szerződések, számlák vagy könyvek gyakran csak egy oldalképet tartalmaznak, valódi szöveget nem — sem keresni, sem szöveget másolni nem lehet bennük. A mousePDF helyben, a böngészőben ismeri fel a szöveget, és láthatatlanul a kép fölé helyezi, így a keresés és a másolás működik, anélkül hogy az oldal kinézetén bármi is változna.
Szövegfelismerés a böngészőben — és mi ebben a különleges
Az OCR olyan feladat, amelynél máskor szinte elkerülhetetlen valamit feltölteni: a felismeréshez nyelvi modell kell, és ez rendszerint egy szerveren van. Itt a böngésződben fut; csak a modell töltődik be, soha nem a fájlod.
Ez pontosan azoknál a dokumentumoknál fontos, amelyeket az ember beszkennel: szerződések, fizetési papírok, orvosi levelek, igazolványmásolatok. Egy szkennelt oldal egy kép — és mielőtt kereshetővé válna, valaminek el kell olvasnia. Hogy ez a valami a saját eszközödön, a saját böngésződben fut, ez a tényleges különbség.
28 nyelv áll rendelkezésre az OCR-hez. A kiválasztott nyelv modellje csak a tényleges futtatáskor töltődik be — az oldal ezáltal könnyű marad, és csak azt töltöd le, amire szükséged van.
Hol éri el a felismerés a korlátait
A nem latin írásrendszerek szándékosan hiányoznak. Nincs cirill, nincs kínai, japán vagy koreai, nincs arab, héber, dévanágari vagy thai. Az ezekhez tartozó modellek jelentősen nagyobbak, és a találati arány érezhetően alacsonyabb — egy olyan eredmény, amelyet karakterenként kell utólag javítani, senkinek sem segít. A görög benne van, mert ebből a szempontból nem tartozik ugyanabba a kategóriába.
A felismerés sosem hibátlan. Pixelekből olvassa vissza, ami egykor szöveg volt. Egy tiszta, egyenes szkennelés nagyon jó eredményeket ad; egy ferde, rossz fényben készült telefonfotó, egy kusza kézírás vagy egy szokatlan dísz-betűtípus jelentősen rosszabbat. Aki a szöveget tovább használja, olvassa át — ez minden OCR-rel feldolgozott verzióra igaz, nem csak erre.
Az oldal kinézete nem változik. A felismert szöveg láthatatlan rétegként kerül a kép fölé: továbbra is a szkennelt képed látod, de kereshetsz és kijelölhetsz benne. A felismerési hibák ezért a képen nem láthatók — csak akkor mutatkoznak meg, ha szöveget másolsz ki.
Az OCR hasznos egy PDF tömörítése után is: ekkor az oldalak képekké válnak, és elveszítik szövegrétegüket — a szövegfelismerés újra létrehozza azt.
Gyakori kérdések
A dokumentumom feltöltésre kerül a szövegfelismeréshez? +
Nem. A felismerés teljes egészében a böngészőben fut, egy helyben betöltött OCR-motor segítségével — a fájl soha nem hagyja el az eszközödet.
Mely nyelvek támogatottak? +
Egy nagyobb választék európai nyelvekből, latin vagy görög írással. Az olyan írásrendszerek, mint a kínai, arab, cirill vagy dévanágari, jelenleg nem támogatottak OCR-hez.
Meddig tart a felismerés? +
Az oldalszámtól és az eszköz teljesítményétől függően néhány másodperctől néhány percig.
Megváltoztatja a szövegfelismerés az oldal kinézetét? +
Nem. Az oldal képe pontosan ugyanaz marad, a felismert szövegréteg láthatatlanul fekszik fölötte — ezáltal csak a keresés és a másolás válik lehetővé.
Mennyire jó a felismerés rosszul szkennelt vagy kézírásos dokumentumoknál? +
A felismerés a tisztán nyomtatott, jól olvasható szövegeknél működik a legjobban. Kézírásos jegyzeteknél vagy erősen zajos szkenneléseknél a pontosság csökken — ekkor egyes karakterek felismerése hibás lehet, vagy hiányozhatnak.
Mely nyelvek ismerhetők fel? +
28, mind latin írással, plusz görög. A nem latin írásrendszerek, mint a cirill, kínai, arab, héber vagy thai, szándékosan nincsenek köztük — ott a találati arány jelentősen rosszabb lenne.
Mennyire pontos a felismerés? +
Egy tiszta, egyenes szkennelésnél nagyon jó; ferde telefonfotóknál, rossz fénynél vagy kézírásnál érezhetően rosszabb. Aki a szöveget tovább használja, olvassa át.
Máshogy néz ki a dokumentumom a szövegfelismerés után? +
Nem. A felismert szöveg láthatatlan rétegként kerül a kép fölé — az oldal úgy néz ki, mint korábban, de kereshető.
Ez is segíthet
PDF tömörítése
Képekben gazdag PDF-ek méretének jelentős csökkentése — az oldalak eközben képekké válnak.
PDF átalakítása PDF/A formátummá
Átalakítás archívumbarát PDF/A formátummá — hatóságok és hosszú távú tárolás számára.
PDF átalakítása Worddé
PDF-szöveg exportálása szerkeszthető Word-fájlként — feltöltés nélkül.
PDF-szöveg szerkesztése
Kattints a PDF-ben meglévő szövegre, és cseréld le újra.