 mousePDF
PDF-i tekstituvastus (OCR) — ilma üleslaadimiseta
Aseta nähtamatu, otsitav tekstikiht skaneeritud või pildina olemasolevate PDF-lehekülgede peale. Tuvastamine toimub täielikult sinu brauseris, sinu faili ei laadita kunagi üles.
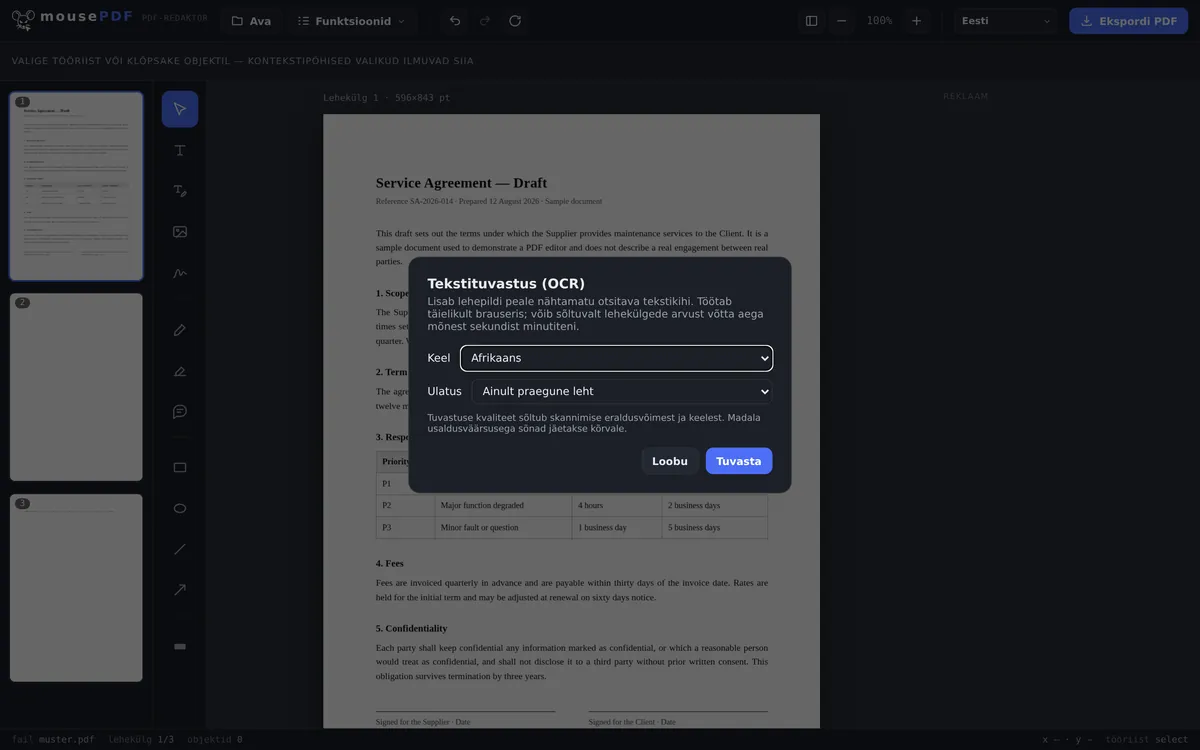
Kolmes sammus
Ava PDF
Lohista skaneeritud või pildipõhine PDF aknasse või vali see.
Vali keel ja ulatus
Määra tuvastuskeel ja otsusta, kas tuvastada ainult praegune lehekülg või kogu dokument.
Ekspordi
Salvesta PDF koos otsitava, nähtamatu tekstikihiga — lehekülje kujutis jääb visuaalselt muutumatuks.
Tüüpiline juhtum: skaneeritud dokumentide otsitavaks tegemine
Skaneeritud lepingud, arved või raamatud sisaldavad tihti ainult lehekülje kujutist, mitte tõelist teksti — neis ei saa otsida ega teksti kopeerida. mousePDF tuvastab teksti kohapeal brauseris ja asetab selle nähtamatult pildi peale, nii et otsimine ja kopeerimine töötavad, ilma et lehekülje välimuses midagi muutuks.
Tekstituvastus brauseris — ja mis selles erilist on
OCR kuulub ülesannete hulka, mille jaoks muidu peaaegu paratamatult midagi üles laaditakse: tuvastamine vajab keelemudelit, ja see asub tavaliselt serveris. Siin töötab see sinu brauseris; laaditakse ainult mudel, mitte kunagi sinu fail.
See on eriti oluline just nende dokumentide puhul, mida skaneeritakse: lepingud, palgatõendid, arstikirjad, isikutunnistuse koopiad. Skaneering on pilt — ja enne kui see muutub otsitavaks, peab miski selle läbi lugema. See, et see miski töötab sinu enda seadmes sinu brauseris, ongi tegelik erinevus.
OCR-i jaoks on saadaval 28 keelt. Valitud keele mudel laaditakse alles tegeliku käivitamise ajal — nii jääb lehekülg kergeks ja sa laadid alla ainult seda, mida vajad.
Kus tuvastamine oma piirini jõuab
Mitteladina kirjasüsteemid puuduvad teadlikult. Ei kirillitsat, ei hiina, jaapani ega korea keelt, ei araabia, heebrea, devanaagari ega tai kirja. Nende mudelid on tunduvalt suuremad ja tabavus märgatavalt madalam — tulemus, mida peab märk-margi haaval parandama, ei aita kedagi. Kreeka keel on kaasas, sest see ei kuulu selles mõttes samasse klassi.
Tuvastamine ei ole kunagi veatu. See loeb pikslitest tagasi, mis kunagi oli tekst. Puhas, sirge skaneering annab väga häid tulemusi; kaldu telefonifoto halva valguse käes, konarlik käekiri või ebatavaline kaunistuskiri tunduvalt halvemaid. Kes teksti edasi kasutab, peaks selle üle kontrollima — see kehtib iga OCR-iga töödeldud versiooni kohta, mitte ainult selle puhul.
Lehekülje välimus ei muutu. Tuvastatud tekst asetatakse nähtamatu kihina pildi peale: sa näed jätkuvalt oma skaneeringut, kuid saad selles otsida ja märkida. Tuvastusvead pole seetõttu pildil nähtavad — need ilmnevad alles siis, kui kopeerid teksti välja.
OCR on kasulik ka pärast PDF-i tihendamist: sel juhul muudetakse leheküljed piltideks ja need kaotavad oma tekstikihi — tekstituvastus loob selle uuesti.
Korduma kippuvad küsimused
Kas mu dokument laaditakse tekstituvastuse jaoks üles? +
Ei. Tuvastamine toimub täielikult brauseris kohapeal laaditud OCR-mootori kaudu — fail ei lahku kunagi sinu seadmest.
Milliseid keeli toetatakse? +
Suurem valik Euroopa keeli ladina või kreeka kirjaga. Kirjasüsteeme nagu hiina, araabia, kirillitsa või devanaagari OCR praegu ei toeta.
Kui kaua tuvastamine aega võtab? +
Olenevalt lehekülgede arvust ja seadme jõudlusest mõnest sekundist mõne minutini.
Kas tekstituvastus muudab lehekülje välimust? +
Ei. Lehekülje kujutis jääb täpselt samaks, tuvastatud tekstikiht asub nähtamatult selle peal — sellega muutub võimalikuks ainult otsimine ja kopeerimine.
Kui hea on tuvastamine halvasti skaneeritud või käsitsi kirjutatud dokumentide puhul? +
Tuvastamine töötab kõige paremini puhtalt trükitud, hästi loetava tekstiga. Käsitsi kirjutatud märkuste või tugevalt müraga skaneeringute puhul täpsus langeb — siis võivad üksikud märgid valesti tuvastatud olla või puududa.
Milliseid keeli tuvastatakse? +
28, kõik ladina kirjaga pluss kreeka keel. Mitteladina kirjasüsteemid nagu kirillitsa, hiina, araabia, heebrea või tai kiri on teadlikult puudu — tabavus oleks seal tunduvalt halvem.
Kui täpne on tuvastamine? +
Puhta, sirge skaneeringu puhul väga hea; kaldu telefonifotode, halva valguse või käekirja puhul märgatavalt halvem. Kes teksti edasi kasutab, peaks selle üle kontrollima.
Kas mu dokument näeb pärast tekstituvastust teistsugune välja? +
Ei. Tuvastatud tekst tuleb nähtamatu kihina pildi peale — lehekülg näeb välja nagu enne, kuid on nüüd otsitav.
See võib samuti abiks olla
PDF-i tihendamine
Vähenda oluliselt piltiderohkete PDF-ide suurust — leheküljed muudetakse selleks piltideks.
PDF-i teisendamine PDF/A-ks
Teisenda arhiivisõbralikuks PDF/A-vorminguks — ametiasutuste ja pikaajalise säilitamise jaoks.
PDF-i teisendamine Wordiks
Ekspordi PDF-tekst redigeeritava Word-failina — ilma üleslaadimiseta.
PDF-teksti redigeerimine
Kliki PDF-is olemasoleval tekstil ja asenda see uuega.