 mousePDF
Разпознаване на текст в PDF (OCR) — без качване
Постави невидим, търсим текстов слой върху сканирани или представени като изображение PDF страници. Разпознаването се извършва изцяло в браузъра ти, файлът ти никога не се качва.
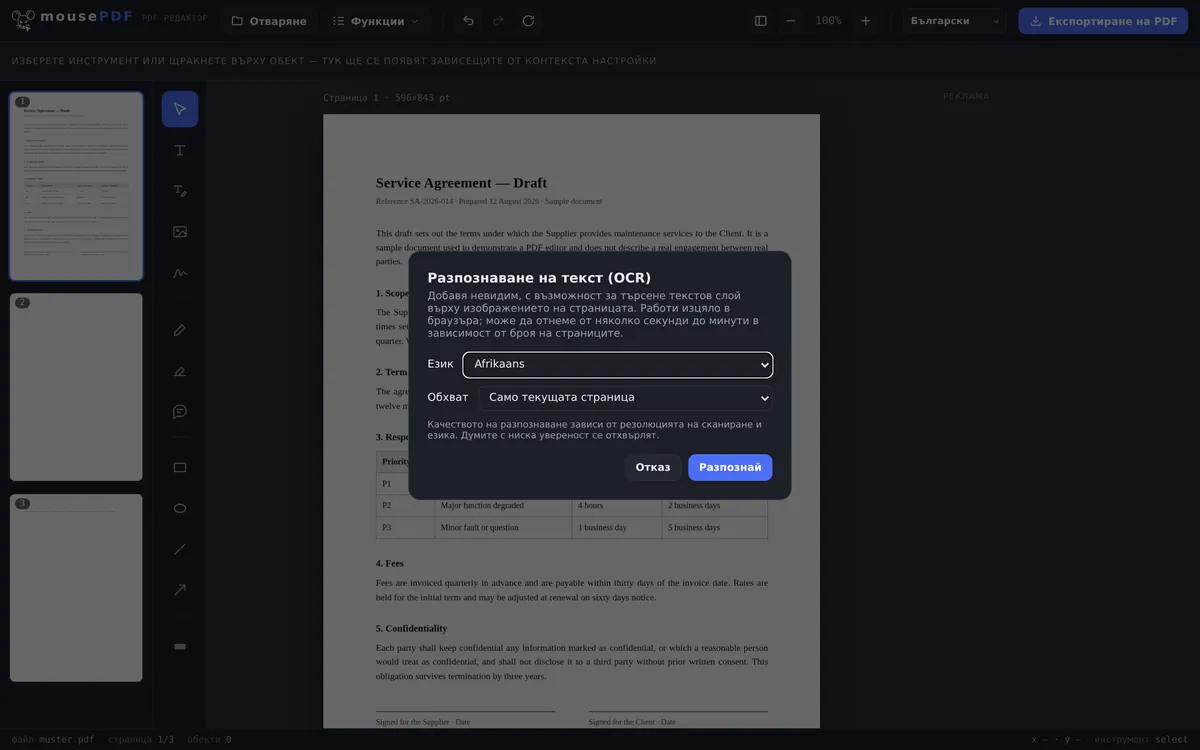
В три стъпки
Отвори PDF
Пусни сканиран или базиран на изображение PDF файл в прозореца или го избери.
Избери език и обхват
Задай език за разпознаване и реши дали да се разпознае само текущата страница или целият документ.
Експортирай
Запази PDF с търсим, невидим текстов слой — изображението на страницата остава оптически непроменено.
Типичен случай: направи сканирани документи търсими
Сканирани договори, фактури или книги често съдържат само изображение на страницата, не истински текст — в тях не може нито да се търси, нито да се копира текст. mousePDF разпознава текста локално в браузъра и го поставя невидимо върху изображението, така че търсенето и копирането да работят, без нищо да се променя във външния вид на страницата.
Разпознаване на текст в браузъра — и какво е особеното в него
OCR е една от задачите, за които обикновено почти неизбежно се качва нещо: разпознаването се нуждае от езиков модел, а той обичайно се намира на сървър. Тук работи в браузъра ти; зарежда се само моделът, никога файлът ти.
Точно това е важно при документите, които обикновено се сканират: договори, фишове за заплата, медицински писма, копия на документи за самоличност. Сканирането е изображение — и преди да стане търсимо, нещо трябва да го прочете. Че точно това нещо работи на собственото ти устройство, в браузъра ти, е истинската разлика.
28 езика са налични за OCR. Моделът за избрания език се зарежда допълнително едва при действителното изпълнение — така страницата остава лека, а ти зареждаш само това, което ти трябва.
Къде разпознаването достига границите си
Нелатинските писмености липсват нарочно. Нито кирилица, нито китайски, японски или корейски, нито арабски, иврит, деванагари или тайски. Моделите за тях са значително по-големи, а процентът на успешно разпознаване — забележимо по-нисък — резултат, който трябва да се коригира знак по знак, не помага на никого. Гръцкият е включен, защото в това отношение не попада в същия клас.
Разпознаването никога не е безгрешно. То чете от пиксели това, което някога е било текст. Чисто сканиране с права ориентация дава много добри резултати; накривена снимка от телефон при лоша светлина, разкривен ръкопис или необичаен декоративен шрифт — забележимо по-лоши. Който продължава да използва текста, трябва да го провери — това важи за всяка обработена с OCR версия, не само за тази.
Външният вид на страницата не се променя. Разпознатият текст се поставя като невидим слой върху изображението: продължаваш да виждаш своя скан, но можеш да търсиш и маркираш в него. Грешките при разпознаване затова не се виждат в изображението — те се проявяват едва когато копираш текст навън.
OCR е полезен и след компресиране на PDF: тогава страниците стават изображения и губят текстовия си слой — разпознаването на текст го създава наново.
Често задавани въпроси
Качва ли се моят документ за разпознаването на текст? +
Не. Разпознаването се извършва изцяло в браузъра чрез локално зареден OCR механизъм — файлът никога не напуска устройството ти.
Кои езици се поддържат? +
По-голям избор от европейски езици с латинска или гръцка писменост. Писмености като китайска, арабска, кирилица или деванагари в момента не се поддържат за OCR.
Колко продължава разпознаването? +
В зависимост от броя страници и мощността на устройството — от няколко секунди до няколко минути.
Променя ли разпознаването на текст външния вид на страницата? +
Не. Изображението на страницата остава напълно същото, разпознатият текстов слой лежи невидимо върху него — само търсенето и копирането стават възможни чрез това.
Колко добро е разпознаването при лошо сканирани или ръкописни документи? +
Разпознаването работи най-добре при чисто отпечатан, добре четим текст. При ръкописни бележки или силно зашумени сканирания точността намалява — тогава отделни знаци могат да бъдат разпознати грешно или да липсват.
Кои езици се разпознават? +
28, всички с латинска писменост плюс гръцки. Нелатински писмености като кирилица, китайски, арабски или тайски нарочно не са включени — процентът на успешно разпознаване там би бил значително по-нисък.
Колко точно е разпознаването? +
При чисто, право сканиране — много добро; при накривени снимки от телефон, лоша светлина или ръкопис — забележимо по-лошо. Който продължава да използва текста, трябва да го провери.
Изглежда ли моят документ различно след разпознаването на текст? +
Не. Разпознатият текст идва като невидим слой върху изображението — страницата изглежда както преди, но вече е търсима.
Това може също да помогне
Компресиране на PDF
Значително намалявай PDF файлове с много изображения — страниците стават изображения при това.
Преобразуване на PDF в PDF/A
Преобразувай в архивно-съвместимия формат PDF/A — за институции и дългосрочно съхранение.
Преобразуване на PDF в Word
Изнеси PDF текст като редактируем файл Word — без качване.
Редактиране на PDF текст
Щракни върху съществуващ текст в PDF-а и го замени с нов.