 mousePDF
PDF-tekstgenkendelse (OCR) — uden upload
Læg et usynligt, søgbart tekstlag over skannede eller billedbaserede PDF-sider. Genkendelsen kører helt i din browser, din fil bliver aldrig uploadet.
I tre trin
Åbn en PDF
Træk en skannet eller billedbaseret PDF ind i vinduet, eller vælg den.
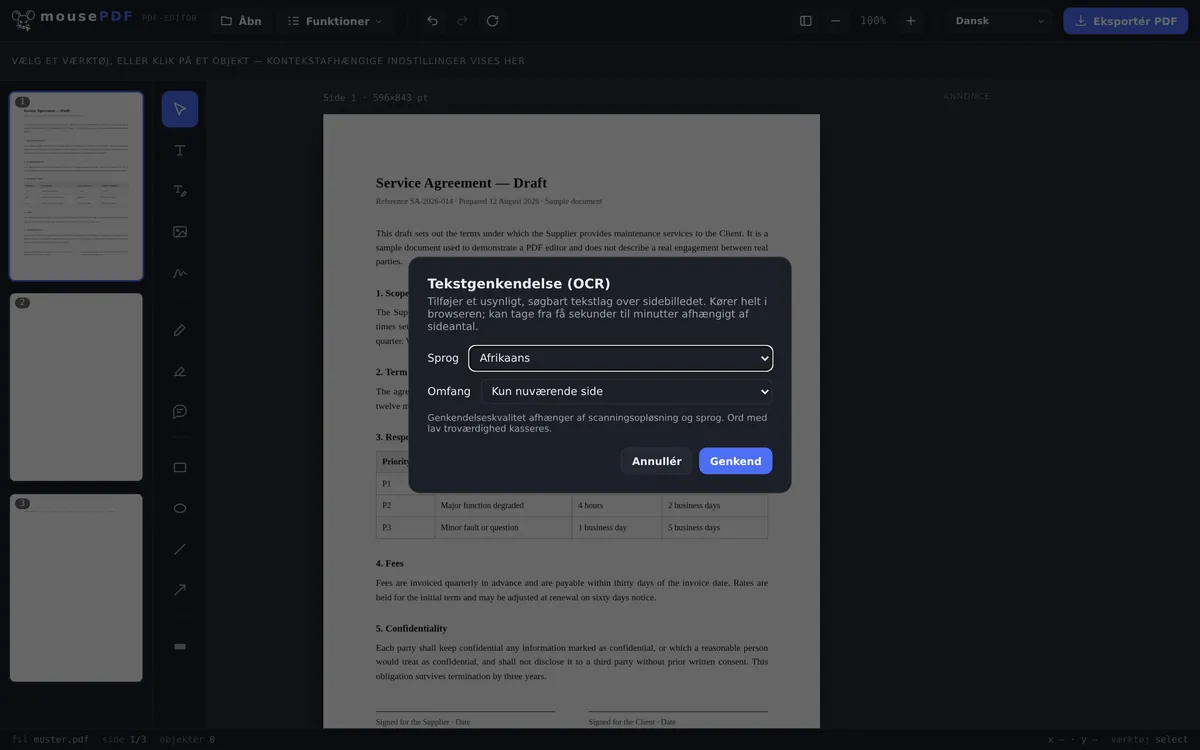
Vælg sprog & omfang
Fastlæg genkendelsessproget, og bestem om kun den aktuelle side eller hele dokumentet skal genkendes.
Eksportér
Gem PDF med søgbart, usynligt tekstlag — sidebilledet forbliver visuelt uændret.
Typisk tilfælde: gøre skannede dokumenter søgbare
Skannede kontrakter, fakturaer eller bøger indeholder ofte kun et sidebillede, ingen ægte tekst — man kan hverken søge i dem eller kopiere tekst. mousePDF genkender teksten lokalt i browseren og lægger den usynligt over billedet, så søgning og kopiering fungerer, uden at sidens udseende ændrer sig.
Tekstgenkendelse i browseren — og hvad der er særligt ved det
OCR hører til de opgaver, hvor man ellers næsten uundgåeligt uploader noget: genkendelsen kræver en sprogmodel, og den ligger normalt på en server. Her kører den i din browser; kun modellen indlæses, aldrig din fil.
Det er netop vigtigt ved de dokumenter, man skanner: kontrakter, lønsedler, lægebreve, kopier af ID-kort. En skanning er et billede — og før den bliver søgbar, skal noget læse den. At dette noget kører på din egen enhed i din browser, er den egentlige forskel.
28 sprog er tilgængelige til OCR. Modellen for det valgte sprog indlæses først, når genkendelsen rent faktisk køres — siden forbliver derfor let, og du henter kun det, du har brug for.
Hvor genkendelsen når sine grænser
Ikke-latinske skriftsystemer mangler bevidst. Ikke kyrillisk, ikke kinesisk, japansk eller koreansk, ikke arabisk, hebraisk, devanagari eller thai. Modellerne til det er betydeligt større, og træfsikkerheden mærkbart lavere — et resultat, man skal rette tegn for tegn, hjælper ingen. Græsk er med, fordi det i den henseende ikke falder i samme kategori.
Genkendelsen er aldrig fejlfri. Den læser ud fra pixels, hvad der engang var tekst. En ren skanning med lige retning giver meget gode resultater; et skævt mobilfoto i dårligt lys, en kruset håndskrift eller en usædvanlig prydskrift markant dårligere. Den, der genbruger teksten, bør læse den igennem — det gælder for enhver OCR-behandlet version, ikke kun denne.
Sidens udseende ændrer sig ikke. Den genkendte tekst lægges som et usynligt lag over billedet: du ser stadig din skanning, men kan søge og markere i den. Genkendelsesfejl er derfor ikke synlige i billedet — de viser sig først, når du kopierer tekst ud.
OCR er også nyttig efter komprimering af en PDF: dér bliver sider til billeder og mister deres tekstlag — tekstgenkendelsen genopretter det.
Ofte stillede spørgsmål
Bliver mit dokument uploadet til tekstgenkendelsen? +
Nej. Genkendelsen kører helt i browseren via en lokalt indlæst OCR-motor — filen forlader aldrig din enhed.
Hvilke sprog understøttes? +
Et bredt udvalg af europæiske sprog med latinsk eller græsk skrift. Skriftsystemer som kinesisk, arabisk, kyrillisk eller devanagari understøttes i øjeblikket ikke til OCR.
Hvor lang tid tager genkendelsen? +
Afhængigt af antal sider og enhedens ydeevne fra få sekunder til nogle minutter.
Ændrer tekstgenkendelsen sidens udseende? +
Nej. Sidebilledet forbliver præcis det samme, det genkendte tekstlag ligger usynligt ovenpå — kun søgning og kopiering bliver dermed muligt.
Hvor god er genkendelsen ved dårligt skannede eller håndskrevne dokumenter? +
Genkendelsen fungerer bedst ved rent trykte, letlæselige tekster. Ved håndskrevne noter eller stærkt støjfyldte skanninger falder nøjagtigheden — så kan enkelte tegn genkendes forkert eller mangle.
Hvilke sprog genkendes? +
28, alle med latinsk skrift plus græsk. Ikke-latinske skriftsystemer som kyrillisk, kinesisk, arabisk, hebraisk eller thai er bevidst ikke med — træfsikkerheden ville være markant dårligere der.
Hvor præcis er genkendelsen? +
Ved en ren, lige skanning meget god; ved skæve mobilfotos, dårligt lys eller håndskrift mærkbart dårligere. Den, der genbruger teksten, bør læse den igennem.
Ser mit dokument anderledes ud efter tekstgenkendelsen? +
Nej. Den genkendte tekst kommer som et usynligt lag over billedet — siden ser ud som før, men er søgbar.
Dette kunne også hjælpe
Komprimér PDF
Formindsk billedtunge PDF-filer markant — siderne bliver til billeder i processen.
Konvertér PDF til PDF/A
Konvertér til det arkivvenlige PDF/A-format — til myndigheder og langtidsopbevaring.
Konvertér PDF til Word
Eksportér PDF-tekst som en redigerbar Word-fil — uden upload.
Redigér PDF-tekst
Klik på eksisterende tekst i PDF'en, og erstat den med ny.