 mousePDF
Pagkilala ng Teksto (OCR) ng PDF — walang pag-upload
Maglagay ng invisible, searchable na text layer sa ibabaw ng mga naka-scan o larawan na pahina ng PDF. Buong tumatakbo ang pagkilala sa browser mo, hindi kailanman ina-upload ang file mo.
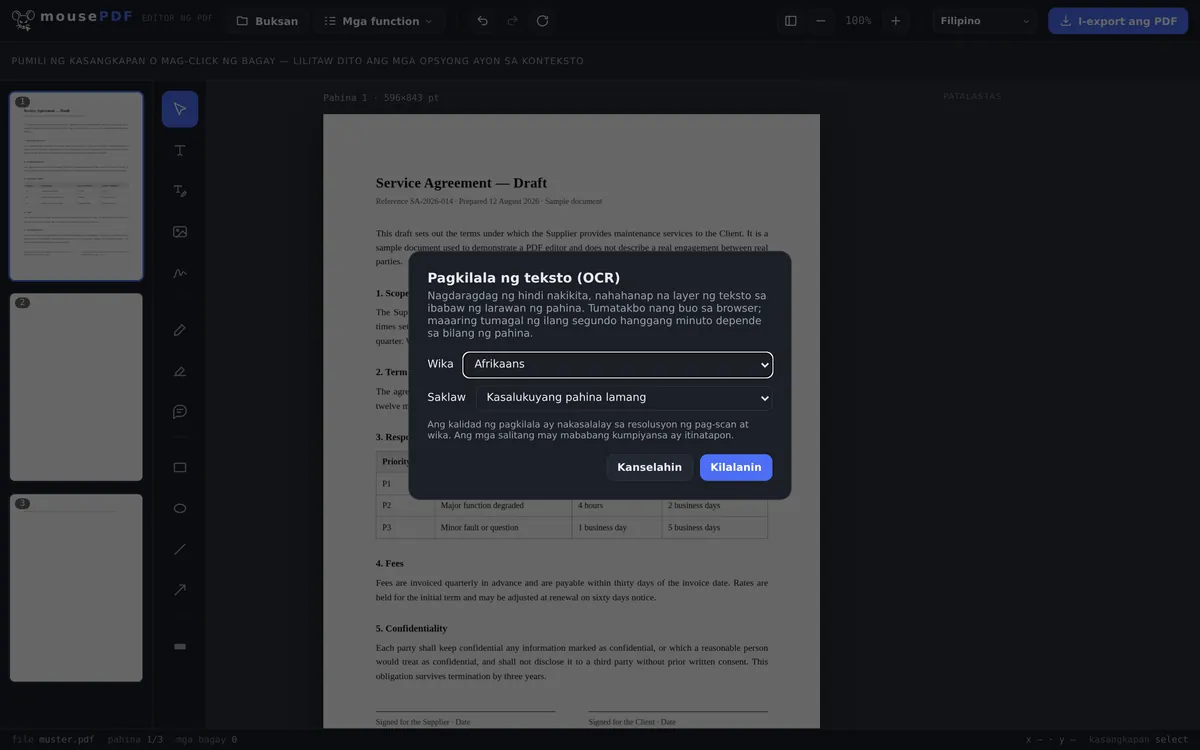
Sa Tatlong Hakbang
Buksan ang PDF
I-drag papasok ang naka-scan o image-based na PDF o piliin ito.
Piliin ang Wika & Saklaw
Itakda ang wika para sa pagkilala at magpasya kung ang kasalukuyang pahina lang o buong dokumento ang kikilalanin.
Mag-export
I-save ang PDF na may searchable, invisible na text layer — hindi nagbabago ang itsura ng pahina.
Karaniwang Kaso: Paggawang Searchable ng mga Naka-scan na Dokumento
Ang mga naka-scan na kontrata, invoice, o libro ay madalas na larawan lang ng pahina, walang tunay na teksto — hindi ka makakapag-search o kumopya ng teksto dito. Kinikilala ng mousePDF ang teksto nang lokal sa browser at inilalagay ito nang invisible sa ibabaw ng larawan, para gumana ang paghahanap at pagkopya, nang hindi nagbabago ang itsura ng pahina.
Pagkilala ng Teksto sa Browser — At Ano ang Espesyal Dito
Kabilang ang OCR sa mga trabahong halos hindi maiiwasang mag-upload ng kahit ano: kailangan ng pagkilala ng language model, at karaniwang nasa server ito. Dito, tumatakbo ito sa browser mo; ang model lang ang ina-load, hindi kailanman ang file mo.
Mahalaga ito eksakto para sa mga dokumentong iniiskan ng mga tao: kontrata, payslip, sulat mula sa doktor, kopya ng ID. Ang isang scan ay larawan — at bago ito maging searchable, may dapat magbasa nito. Ang katotohanang tumatakbo ito sa sarili mong device, sa sarili mong browser, ang tunay na pagkakaiba.
28 wika ang magagamit para sa OCR. Ang model ng piniling wika ay ina-load lang habang tumatakbo — kaya nananatiling magaan ang page, at ina-load mo lang ang kailangan mo.
Saan Umaabot ang Limitasyon ng Pagkilala
Sadyang kulang ang mga non-Latin na script. Walang Cyrillic, walang Chinese, Japanese, o Korean, walang Arabic, Hebrew, Devanagari, o Thai. Mas malaki ang mga model para sa mga ito at mas mababa ang accuracy — isang resultang kailangang ayusin character-by-character ay hindi tumutulong kaninuman. Kasama ang Greek dahil hindi ito napapabilang sa parehong kategorya sa aspektong ito.
Hindi kailanman perpekto ang pagkilala. Binabasa nito mula sa pixel kung ano ang minsang teksto. Ang isang malinis na scan na tuwid ang direksyon ay nagbibigay ng napakagandang resulta; ang isang baluktot na litrato mula sa cellphone na may masamang ilaw, isang mahirap basahing sulat-kamay, o isang di-pangkaraniwang decorative na font ay mas malamang na magbigay ng mas mahinang resulta. Ang sinumang gagamit muli ng teksto ay dapat itong suriin muna — totoo ito sa bawat OCR na na-process, hindi lang sa mousePDF.
Hindi nagbabago ang itsura ng pahina. Ang kinilalang teksto ay inilalagay bilang invisible na layer sa ibabaw ng larawan: nakikita mo pa rin ang scan mo, pero pwede ka nang mag-search at mag-highlight dito. Kaya hindi nakikita sa larawan ang mga pagkakamali sa pagkilala — lalabas lang ito kapag kinopya mo ang teksto.
Kapaki-pakinabang din ang OCR pagkatapos ng pag-compress ng isang PDF: nagiging larawan doon ang mga pahina at nawawala ang text layer nito — muling ginagawa ito ng pagkilala ng teksto.
Mga Madalas na Tanong
Ina-upload ba ang dokumento ko para sa pagkilala ng teksto? +
Hindi. Buong tumatakbo ang pagkilala sa browser sa pamamagitan ng isang lokal na na-load na OCR engine — hindi kailanman umaalis ang file sa device mo.
Anong mga wika ang suportado? +
Malaking seleksyon ng mga wikang Europeo na may Latin o Greek na script. Ang mga script tulad ng Chinese, Arabic, Cyrillic, o Devanagari ay hindi kasalukuyang suportado para sa OCR.
Gaano katagal ang pagkilala? +
Depende sa bilang ng pahina at kakayahan ng device, ilang segundo hanggang ilang minuto.
Nababago ba ng pagkilala ng teksto ang itsura ng pahina? +
Hindi. Eksaktong pareho ang larawan ng pahina, nasa ibabaw nito ang invisible na kinilalang text layer — posible lang dahil dito ang paghahanap at pagkopya.
Gaano kagaling ang pagkilala sa mga hindi magandang naka-scan o sulat-kamay na dokumento? +
Pinakamagaling gumana ang pagkilala sa malinaw na naka-print, madaling basahing teksto. Sa mga sulat-kamay na tala o maingay na scan, bumababa ang accuracy — pwedeng mali ang pagkakilala o mawala ang ilang character.
Anong mga wika ang nakikilala? +
28, lahat may Latin na script kasama ang Greek. Sadyang wala ang mga non-Latin na script tulad ng Cyrillic, Chinese, Arabic, Hebrew, o Thai — mas mahina ang accuracy doon.
Gaano katumpak ang pagkilala? +
Napakagaling sa isang malinis, tuwid na scan; halatang mas mahina sa baluktot na litrato mula sa cellphone, masamang ilaw, o sulat-kamay. Ang sinumang gagamit muli ng teksto ay dapat itong suriin muna.
Iba na ba ang itsura ng dokumento ko pagkatapos ng pagkilala ng teksto? +
Hindi. Dumarating ang kinilalang teksto bilang invisible na layer sa ibabaw ng larawan — pareho ang itsura ng pahina gaya ng dati, pero searchable na ito.
Baka makatulong din ito
I-compress ang PDF
Malaki ang pagpapaliit sa mga PDF na maraming larawan — nagiging larawan ang mga pahina dito.
I-convert ang PDF sa PDF/A
I-convert sa archive-friendly na PDF/A format — para sa mga ahensya at pangmatagalang storage.
I-convert ang PDF sa Word
I-export ang teksto ng PDF bilang editable na Word file — walang pag-upload.
I-edit ang Teksto ng PDF
I-click ang umiiral na teksto sa PDF at palitan ng bago.