 mousePDF
Rozpoznávání textu PDF (OCR) — bez nahrávání
Polož neviditelnou, prohledávatelnou textovou vrstvu přes naskenované nebo jako obrázek existující stránky PDF. Rozpoznávání probíhá zcela v tvém prohlížeči, tvůj soubor se nikdy nenahrává.
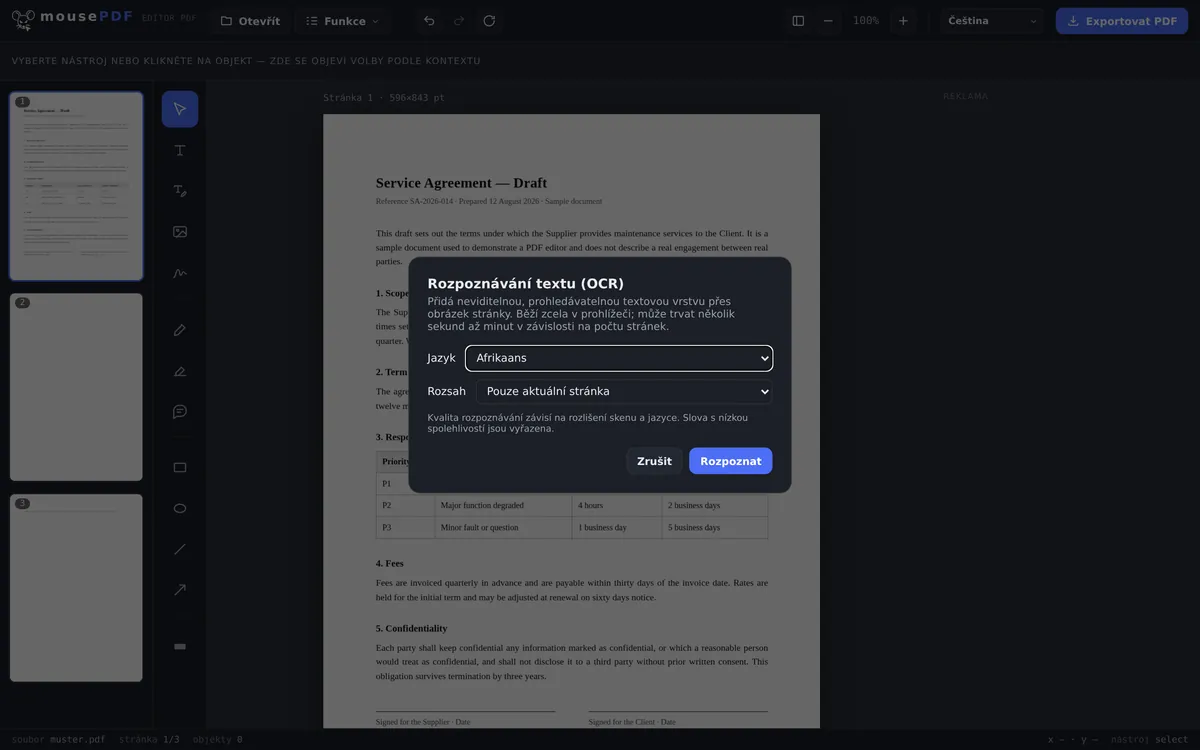
Ve třech krocích
Otevři PDF
Přetáhni naskenované nebo obrázkové PDF do okna nebo ho vyber.
Zvol jazyk & rozsah
Nastav jazyk rozpoznávání a rozhodni, zda se má rozpoznat jen aktuální stránka nebo celý dokument.
Export
Ulož PDF s prohledávatelnou, neviditelnou textovou vrstvou — obrázek stránky zůstává opticky nezměněn.
Typický případ: udělat naskenované dokumenty prohledávatelnými
Naskenované smlouvy, faktury nebo knihy často obsahují jen obrázek stránky, žádný skutečný text — nelze v nich ani hledat, ani kopírovat text. mousePDF rozpozná text lokálně v prohlížeči a položí ho neviditelně přes obrázek, takže hledání a kopírování fungují, aniž by se na vzhledu stránky cokoli změnilo.
Rozpoznávání textu v prohlížeči — a co je na tom zvláštní
OCR patří k úkolům, kvůli kterým se jinak téměř nutně něco nahrává: rozpoznávání potřebuje jazykový model a ten obvykle leží na serveru. Zde běží ve tvém prohlížeči; nahrává se jen model, nikdy tvůj soubor.
To je důležité právě u dokumentů, které se skenují: smlouvy, výplatní pásky, lékařské zprávy, kopie dokladů. Sken je obrázek — a než se stane prohledávatelným, musí ho něco přečíst. Že toto něco běží na tvém vlastním zařízení v tvém prohlížeči, je ten skutečný rozdíl.
K dispozici pro OCR je 28 jazyků. Model zvoleného jazyka se dotáhne až při skutečném spuštění — stránka tak zůstává lehká a stahuješ jen to, co potřebuješ.
Kde rozpoznávání naráží na své hranice
Nelatinská písma záměrně chybí. Žádná cyrilice, žádná čínština, japonština nebo korejština, žádná arabština, hebrejština, dévanágarí nebo thajština. Modely pro ně jsou výrazně větší a úspěšnost rozpoznání citelně nižší — výsledek, který by se musel opravovat znak po znaku, nikomu nepomůže. Řečtina je zahrnuta, protože v tomto ohledu nespadá do stejné kategorie.
Rozpoznávání není nikdy bezchybné. Zpětně čte z pixelů, co bylo kdysi text. Čistý sken s rovným natočením přináší velmi dobré výsledky; nakřivo vyfocený mobilní snímek při špatném světle, klikaté rukopisné písmo nebo neobvyklé ozdobné písmo výrazně horší. Kdo text dále používá, měl by ho zkontrolovat — to platí pro jakoukoli verzi zpracovanou OCR, nejen pro tuto.
Vzhled stránky se nemění. Rozpoznaný text se položí jako neviditelná vrstva přes obrázek: stále vidíš svůj sken, ale můžeš v něm hledat a označovat text. Chyby rozpoznávání proto nejsou v obrázku vidět — projeví se, až text zkopíruješ ven.
OCR je užitečné i po komprimaci PDF: stránky se přitom stanou obrázky a ztratí svou textovou vrstvu — rozpoznávání textu ji vytvoří znovu.
Časté dotazy
Nahrává se můj dokument kvůli rozpoznávání textu? +
Ne. Rozpoznávání probíhá zcela v prohlížeči přes lokálně načtený OCR modul — soubor nikdy neopustí tvé zařízení.
Jaké jazyky jsou podporovány? +
Větší výběr evropských jazyků s latinkou nebo řeckým písmem. Písma jako čínština, arabština, cyrilice nebo dévanágarí nejsou pro OCR aktuálně podporována.
Jak dlouho rozpoznávání trvá? +
Podle počtu stránek a výkonu zařízení několik sekund až pár minut.
Mění rozpoznávání textu vzhled stránky? +
Ne. Obrázek stránky zůstává přesně stejný, rozpoznaná textová vrstva leží neviditelně nad ním — tím se umožní jen hledání a kopírování.
Jak dobré je rozpoznávání u špatně naskenovaných nebo rukopisných dokumentů? +
Rozpoznávání funguje nejlépe u čistě vytištěných, dobře čitelných textů. U rukopisných poznámek nebo silně zašuměných skenů přesnost klesá — pak mohou být jednotlivé znaky rozpoznány špatně nebo chybět.
Jaké jazyky se rozpoznávají? +
28, všechny s latinkou plus řečtina. Nelatinská písma jako cyrilice, čínština, arabština, hebrejština nebo thajština záměrně chybí — úspěšnost by tam byla výrazně horší.
Jak přesné je rozpoznávání? +
U čistého, rovného skenu velmi dobré; u nakřivo vyfocených mobilních snímků, špatného světla nebo rukopisu znatelně horší. Kdo text dále používá, měl by ho zkontrolovat.
Vypadá můj dokument po rozpoznávání textu jinak? +
Ne. Rozpoznaný text přichází jako neviditelná vrstva přes obrázek — stránka vypadá jako předtím, ale je prohledávatelná.
To by ti také mohlo pomoct
Komprimovat PDF
Výrazně zmenšit PDF s mnoha obrázky — stránky se přitom stanou obrázky.
Převést PDF na PDF/A
Převést do archivního formátu PDF/A — pro úřady a dlouhodobé uchování.
Převést PDF na Word
Exportovat text PDF jako upravitelný soubor Word — bez nahrávání.
Upravit text PDF
Klikni na existující text v PDF a nahraď ho novým.