 mousePDF
Αναγνώριση κειμένου PDF (OCR) — χωρίς μεταφόρτωση
Τοποθέτησε ένα αόρατο, αναζητήσιμο επίπεδο κειμένου πάνω από σαρωμένες ή σε μορφή εικόνας σελίδες PDF. Η αναγνώριση γίνεται εξ ολοκλήρου στο πρόγραμμα περιήγησής σου, το αρχείο σου δεν μεταφορτώνεται ποτέ.
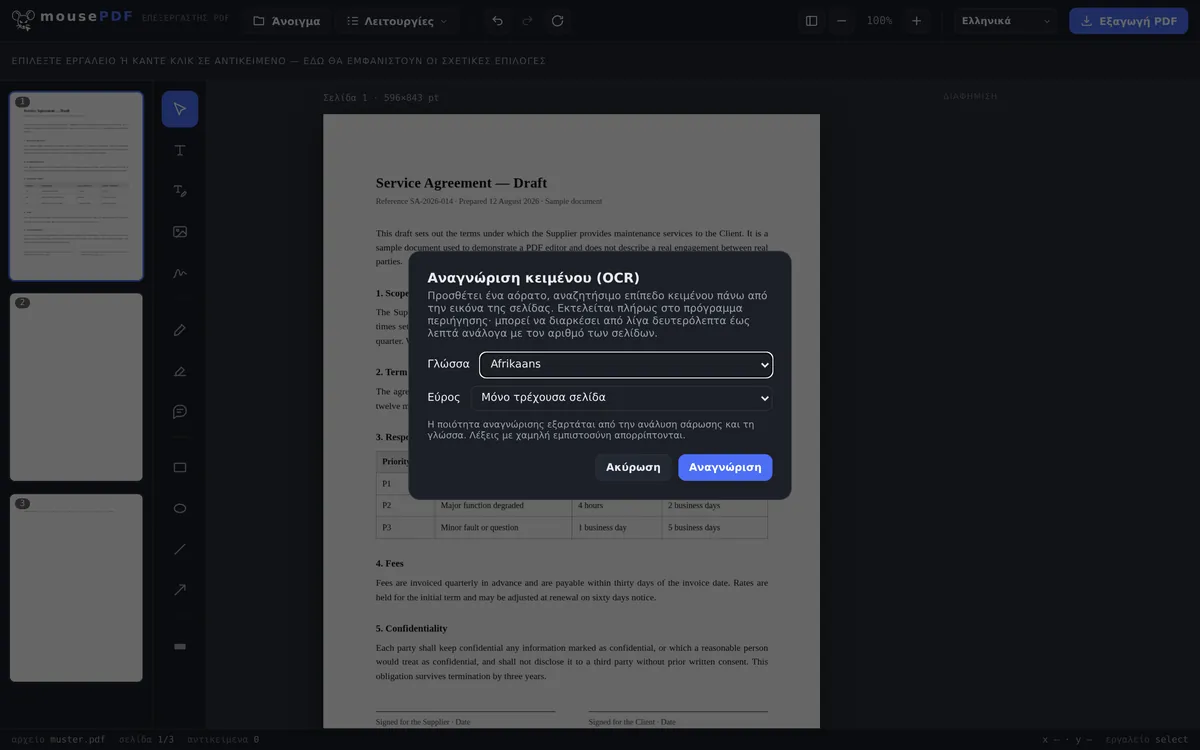
Σε τρία βήματα
Άνοιγμα PDF
Σύρε το σαρωμένο ή βασισμένο σε εικόνα PDF στο παράθυρο με μεταφορά και απόθεση ή επίλεξέ το.
Επιλογή γλώσσας & έκτασης
Όρισε τη γλώσσα αναγνώρισης και αποφάσισε αν θα αναγνωριστεί μόνο η τρέχουσα σελίδα ή ολόκληρο το έγγραφο.
Εξαγωγή
Αποθήκευσε το PDF με αναζητήσιμο, αόρατο επίπεδο κειμένου — η εικόνα της σελίδας παραμένει οπτικά αμετάβλητη.
Τυπική περίπτωση: να κάνεις αναζητήσιμα σαρωμένα έγγραφα
Σαρωμένα συμβόλαια, τιμολόγια ή βιβλία περιέχουν συχνά μόνο μια εικόνα της σελίδας, όχι πραγματικό κείμενο — δεν μπορείς ούτε να αναζητήσεις ούτε να αντιγράψεις κείμενο σε αυτά. Το mousePDF αναγνωρίζει το κείμενο τοπικά στο πρόγραμμα περιήγησης και το τοποθετεί αόρατα πάνω από την εικόνα, ώστε η αναζήτηση και η αντιγραφή να λειτουργούν, χωρίς να αλλάζει τίποτα στην εμφάνιση της σελίδας.
Αναγνώριση κειμένου στο πρόγραμμα περιήγησης — και τι είναι ιδιαίτερο σε αυτό
Το OCR ανήκει στις εργασίες για τις οποίες αλλιώς σχεδόν αναγκαστικά μεταφορτώνεις κάτι: η αναγνώριση χρειάζεται ένα γλωσσικό μοντέλο, και αυτό συνήθως βρίσκεται σε έναν διακομιστή. Εδώ λειτουργεί στο πρόγραμμα περιήγησής σου· φορτώνεται μόνο το μοντέλο, ποτέ το αρχείο σου.
Αυτό είναι σημαντικό ακριβώς στα έγγραφα που σαρώνει κανείς: συμβόλαια, εκκαθαρίσεις μισθοδοσίας, ιατρικές βεβαιώσεις, αντίγραφα ταυτότητας. Μια σάρωση είναι εικόνα — και πριν γίνει αναζητήσιμη, κάτι πρέπει να τη διαβάσει. Ότι αυτό το κάτι λειτουργεί στη δική σου συσκευή, στο δικό σου πρόγραμμα περιήγησης, είναι η πραγματική διαφορά.
28 γλώσσες είναι διαθέσιμες για OCR. Το μοντέλο της επιλεγμένης γλώσσας φορτώνεται μόνο κατά την πραγματική εκτέλεση — έτσι η σελίδα παραμένει ελαφριά, και φορτώνεις μόνο ό,τι χρειάζεσαι.
Πού φτάνει η αναγνώριση στα όριά της
Οι μη λατινικές γραφές λείπουν σκόπιμα. Κανένα κυριλλικό, κανένα κινέζικο, ιαπωνικό ή κορεατικό, καμία αραβική, εβραϊκή, ντεβαναγκάρι ή ταϊλανδέζικη γραφή. Τα μοντέλα γι' αυτές είναι σημαντικά μεγαλύτερα και το ποσοστό επιτυχίας αισθητά χαμηλότερο — ένα αποτέλεσμα που πρέπει να διορθώνεις χαρακτήρα προς χαρακτήρα δεν βοηθάει κανέναν. Τα ελληνικά συμπεριλαμβάνονται, επειδή από αυτή την άποψη δεν ανήκουν στην ίδια κατηγορία.
Η αναγνώριση δεν είναι ποτέ αλάνθαστη. Διαβάζει από εικονοστοιχεία αυτό που κάποτε ήταν κείμενο. Μια καθαρή σάρωση με ίσιο προσανατολισμό δίνει πολύ καλά αποτελέσματα· μια στραβή φωτογραφία κινητού με κακό φωτισμό, ένας δυσανάγνωστος γραφικός χαρακτήρας ή μια ασυνήθιστη διακοσμητική γραμματοσειρά αισθητά χειρότερα. Όποιος επαναχρησιμοποιεί το κείμενο, θα πρέπει να το ελέγξει — αυτό ισχύει για κάθε έκδοση επεξεργασμένη με OCR, όχι μόνο για αυτήν.
Η εμφάνιση της σελίδας δεν αλλάζει. Το αναγνωρισμένο κείμενο τοποθετείται ως αόρατο επίπεδο πάνω από την εικόνα: εξακολουθείς να βλέπεις τη σάρωσή σου, αλλά μπορείς να αναζητήσεις και να επισημάνεις σε αυτήν. Τα σφάλματα αναγνώρισης δεν είναι επομένως ορατά στην εικόνα — εμφανίζονται μόνο όταν αντιγράφεις κείμενο.
Το OCR είναι χρήσιμο και μετά τη συμπίεση ενός PDF: εκεί οι σελίδες γίνονται εικόνες και χάνουν το επίπεδο κειμένου τους — η αναγνώριση κειμένου το δημιουργεί εκ νέου.
Συχνές ερωτήσεις
Μεταφορτώνεται το έγγραφό μου για την αναγνώριση κειμένου; +
Όχι. Η αναγνώριση γίνεται εξ ολοκλήρου στο πρόγραμμα περιήγησης μέσω μιας τοπικά φορτωμένης μηχανής OCR — το αρχείο δεν εγκαταλείπει ποτέ τη συσκευή σου.
Ποιες γλώσσες υποστηρίζονται; +
Μια μεγαλύτερη επιλογή ευρωπαϊκών γλωσσών με λατινική ή ελληνική γραφή. Γραφές όπως τα κινέζικα, τα αραβικά, τα κυριλλικά ή το ντεβαναγκάρι δεν υποστηρίζονται προς το παρόν για OCR.
Πόσο διαρκεί η αναγνώριση; +
Ανάλογα με τον αριθμό σελίδων και την απόδοση της συσκευής, από μερικά δευτερόλεπτα έως λίγα λεπτά.
Αλλάζει η αναγνώριση κειμένου την εμφάνιση της σελίδας; +
Όχι. Η εικόνα της σελίδας παραμένει ακριβώς ίδια, το αναγνωρισμένο επίπεδο κειμένου βρίσκεται αόρατο από πάνω — μόνο η αναζήτηση και η αντιγραφή γίνονται έτσι δυνατές.
Πόσο καλή είναι η αναγνώριση σε κακά σαρωμένα ή χειρόγραφα έγγραφα; +
Η αναγνώριση λειτουργεί καλύτερα σε καθαρά τυπωμένα, ευανάγνωστα κείμενα. Σε χειρόγραφες σημειώσεις ή έντονα θορυβώδεις σαρώσεις μειώνεται η ακρίβεια — τότε μεμονωμένοι χαρακτήρες μπορεί να αναγνωριστούν λάθος ή να λείπουν.
Ποιες γλώσσες αναγνωρίζονται; +
28, όλες με λατινική γραφή συν τα ελληνικά. Οι μη λατινικές γραφές όπως τα κυριλλικά, τα κινέζικα, τα αραβικά, τα εβραϊκά ή τα ταϊλανδέζικα δεν συμπεριλαμβάνονται σκόπιμα — το ποσοστό επιτυχίας θα ήταν εκεί αισθητά χειρότερο.
Πόσο ακριβής είναι η αναγνώριση; +
Σε μια καθαρή, ίσια σάρωση πολύ καλή· σε στραβές φωτογραφίες κινητού, κακό φωτισμό ή χειρόγραφο αισθητά χειρότερη. Όποιος επαναχρησιμοποιεί το κείμενο, θα πρέπει να το ελέγξει.
Φαίνεται το έγγραφό μου διαφορετικό μετά την αναγνώριση κειμένου; +
Όχι. Το αναγνωρισμένο κείμενο έρχεται ως αόρατο επίπεδο πάνω από την εικόνα — η σελίδα φαίνεται όπως πριν, αλλά είναι αναζητήσιμη.
Αυτό μπορεί επίσης να βοηθήσει
Συμπίεση PDF
Σμίκρυνε σημαντικά PDF με πολλές εικόνες — οι σελίδες μετατρέπονται τότε σε εικόνες.
Μετατροπή PDF σε PDF/A
Μετέτρεψε στη φιλική για αρχειοθέτηση μορφή PDF/A — για δημόσιες υπηρεσίες και μακροπρόθεσμη αποθήκευση.
Μετατροπή PDF σε Word
Εξήγαγε το κείμενο PDF ως επεξεργάσιμο αρχείο Word — χωρίς μεταφόρτωση.
Επεξεργασία κειμένου PDF
Κάνε κλικ σε υπάρχον κείμενο στο PDF και αντικατέστησέ το με νέο.