 mousePDF
Rozpoznávanie textu PDF (OCR) — bez nahrávania
Polož neviditeľnú, vyhľadateľnú textovú vrstvu nad naskenované alebo ako obrázok uložené strany PDF. Rozpoznávanie prebieha úplne v tvojom prehliadači, tvoj súbor sa nikdy nenahráva.
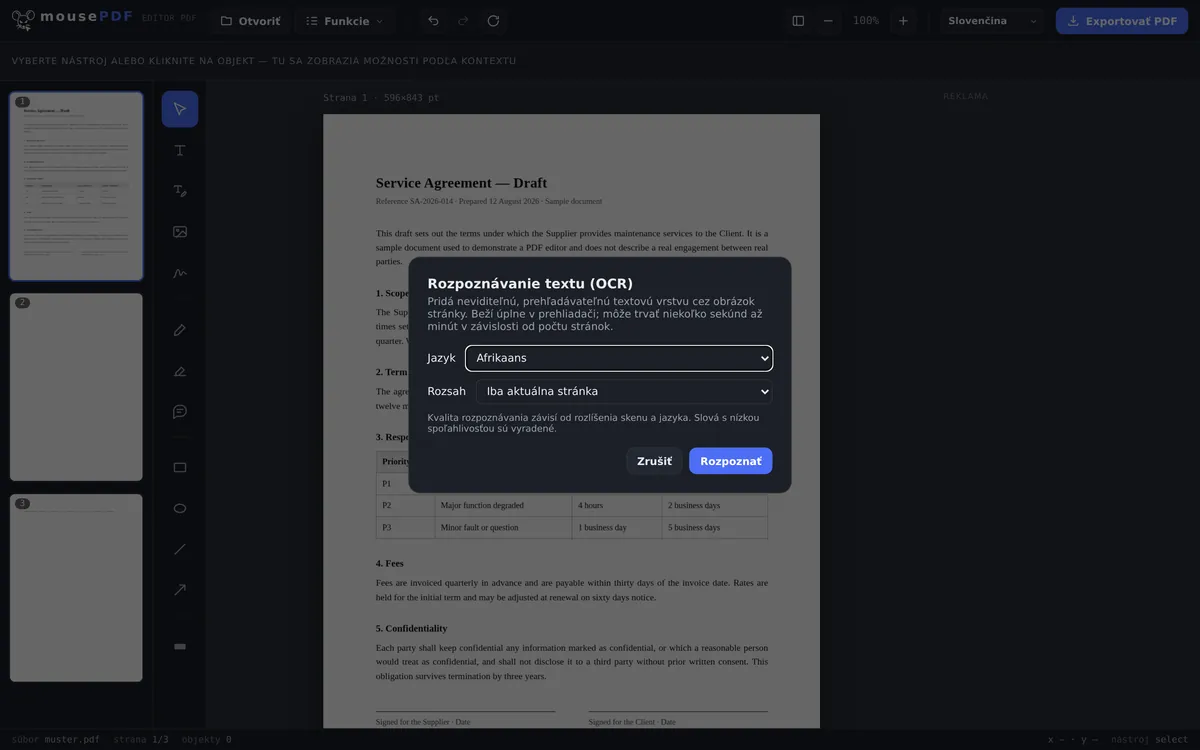
V troch krokoch
Otvoriť PDF
Naskenované alebo obrázkové PDF pretiahni myšou (drag-and-drop) do okna alebo vyber súbor.
Zvoliť jazyk a rozsah
Nastav jazyk rozpoznávania a rozhodni, či sa má rozpoznať iba aktuálna strana alebo celý dokument.
Exportovať
Ulož PDF s vyhľadateľnou, neviditeľnou textovou vrstvou — obrázok strany zostáva opticky nezmenený.
Typický prípad: sprav naskenované dokumenty vyhľadateľnými
Naskenované zmluvy, faktúry alebo knihy často obsahujú iba obrázok strany, žiadny skutočný text — nedá sa v nich vyhľadávať ani z nich kopírovať text. mousePDF rozpozná text lokálne v prehliadači a položí ho neviditeľne nad obrázok, takže vyhľadávanie a kopírovanie fungujú bez toho, aby sa na vzhľade strany čokoľvek zmenilo.
Rozpoznávanie textu v prehliadači — a čo je na tom výnimočné
OCR patrí k úlohám, pri ktorých sa inak takmer nevyhnutne niečo nahráva: rozpoznávanie potrebuje jazykový model, a ten zvyčajne leží na serveri. Tu beží v tvojom prehliadači; nahráva sa iba model, nikdy tvoj súbor.
To je dôležité práve pri dokumentoch, ktoré sa skenujú: zmluvy, výplatné pásky, lekárske správy, kópie dokladov. Sken je obrázok — a skôr než sa stane vyhľadateľným, musí ho niečo prečítať. Že toto niečo beží na tvojom vlastnom zariadení v tvojom prehliadači, je ten skutočný rozdiel.
K dispozícii je 28 jazykov pre OCR. Model zvoleného jazyka sa dodatočne stiahne až pri skutočnom spustení — stránka tak zostáva ľahká a sťahuješ iba to, čo potrebuješ.
Kde rozpoznávanie naráža na svoje hranice
Nelatinské písma zámerne chýbajú. Žiadna cyrilika, žiadna čínština, japončina či kórejčina, žiadna arabčina, hebrejčina, dévanágarí či thajčina. Modely pre ne sú výrazne väčšie a úspešnosť citeľne nižšia — výsledok, ktorý treba opravovať znak po znaku, nikomu nepomôže. Gréčtina je zaradená, pretože v tomto smere nepatrí do rovnakej kategórie.
Rozpoznávanie nikdy nie je bezchybné. Číta z pixelov späť to, čo bolo kedysi textom. Čistý sken s rovnou orientáciou dáva veľmi dobré výsledky; nakrivo odfotená mobilom pri zlom svetle, kostrbatý rukopis alebo nezvyčajné ozdobné písmo výrazne horšie. Kto text ďalej používa, mal by ho skontrolovať — to platí pre každú OCR spracovanú verziu, nielen pre túto.
Vzhľad strany sa nemení. Rozpoznaný text sa vloží ako neviditeľná vrstva nad obrázok: naďalej vidíš svoj sken, ale dá sa v ňom vyhľadávať a označovať. Chyby rozpoznávania preto nie sú na obrázku viditeľné — prejavia sa až vtedy, keď text vykopíruješ von.
OCR je užitočné aj po komprimovaní PDF: strany sa pritom stanú obrázkami a stratia svoju textovú vrstvu — rozpoznávanie textu ju vytvorí znova.
Časté otázky
Nahráva sa môj dokument kvôli rozpoznávaniu textu niekam? +
Nie. Rozpoznávanie prebieha úplne v prehliadači cez lokálne načítaný OCR modul — súbor nikdy neopustí tvoje zariadenie.
Ktoré jazyky sú podporované? +
Väčší výber európskych jazykov s latinským alebo gréckym písmom. Písma ako čínština, arabčina, cyrilika alebo dévanágarí aktuálne pre OCR podporované nie sú.
Ako dlho trvá rozpoznávanie? +
Podľa počtu strán a výkonu zariadenia niekoľko sekúnd až pár minút.
Mení rozpoznávanie textu vzhľad strany? +
Nie. Obrázok strany zostáva presne rovnaký, rozpoznaná textová vrstva leží nad ním neviditeľne — umožňuje iba vyhľadávanie a kopírovanie.
Aké dobré je rozpoznávanie pri zle naskenovaných alebo ručne písaných dokumentoch? +
Rozpoznávanie funguje najlepšie pri čisto vytlačených, dobre čitateľných textoch. Pri ručne písaných poznámkach alebo silne zašumených skenoch presnosť klesá — vtedy môžu byť jednotlivé znaky rozpoznané nesprávne alebo chýbať.
Ktoré jazyky sa rozpoznávajú? +
28, všetky s latinským písmom plus gréčtina. Nelatinské písma ako cyrilika, čínština, arabčina, hebrejčina alebo thajčina zámerne chýbajú — úspešnosť by tam bola výrazne horšia.
Aké presné je rozpoznávanie? +
Pri čistom, rovnom skene veľmi dobré; pri nakrivo odfotených mobilom, zlom svetle alebo rukopise citeľne horšie. Kto text ďalej používa, mal by ho skontrolovať.
Vyzerá môj dokument po rozpoznávaní textu inak? +
Nie. Rozpoznaný text príde ako neviditeľná vrstva nad obrázok — strana vyzerá ako predtým, je však vyhľadateľná.
Toto by mohlo tiež pomôcť
Komprimovať PDF
Výrazne zmenši PDF s množstvom obrázkov — strany sa pritom stanú obrázkami.
Previesť PDF na PDF/A
Prevod do archívne vhodného formátu PDF/A — pre úrady a dlhodobé uchovávanie.
Previesť PDF na Word
Export textu PDF ako upraviteľného súboru Word — bez nahrávania.
Upraviť text v PDF
Klikni na existujúci text v PDF a nahraď ho novým.