 mousePDF
Riconoscimento testo PDF (OCR) senza caricamento
Aggiungi un livello di testo invisibile e ricercabile sopra pagine PDF scansionate o presenti come immagine. Il riconoscimento avviene interamente nel tuo browser, il tuo file non viene mai caricato.
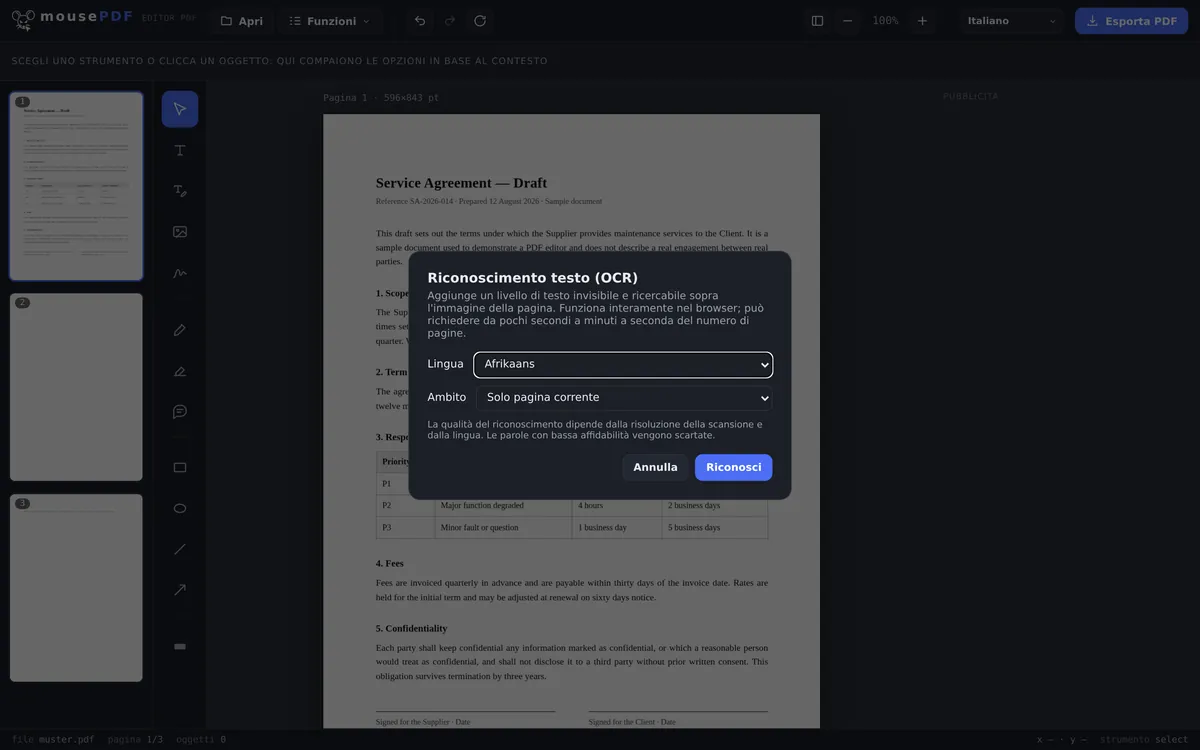
In tre passaggi
Aprire il PDF
Trascina il PDF scansionato o basato su immagine nella finestra o selezionalo.
Scegliere lingua e ambito
Definisci la lingua di riconoscimento e decidi se elaborare solo la pagina attuale o l'intero documento.
Esportare
Salva il PDF con livello di testo ricercabile e invisibile. L'immagine della pagina resta visivamente invariata.
Rendere ricercabili i documenti scansionati
Contratti, fatture o libri scansionati spesso contengono solo l'immagine della pagina, nessun testo reale, non è possibile cercare né copiare testo. mousePDF riconosce il testo localmente nel browser e lo colloca in modo invisibile sopra l'immagine, così ricerca e copia funzionano senza che l'aspetto della pagina cambi.
Perché il riconoscimento sul proprio dispositivo è insolito
L'OCR è uno di quei compiti per cui altrimenti è quasi inevitabile caricare qualcosa: il riconoscimento richiede un modello linguistico, che di solito risiede su un server. Qui invece funziona nel tuo browser; viene caricato solo il modello, mai il tuo file.
Questo è importante proprio con i documenti che si scansionano: contratti, buste paga, referti medici, copie di documenti d'identità. Una scansione è un'immagine, e prima che diventi ricercabile, qualcosa deve leggerla. Che questo qualcosa funzioni sul tuo dispositivo, nel tuo browser, è la vera differenza.
Sono disponibili 28 lingue per l'OCR. Il modello della lingua scelta viene scaricato solo durante l'esecuzione effettiva. La pagina resta così leggera, e scarichi solo ciò di cui hai bisogno.
Dove il riconoscimento raggiunge i suoi limiti
Le scritture non latine mancano deliberatamente. Niente cirillico, niente cinese, giapponese o coreano, niente arabo, ebraico, devanagari o thailandese. I modelli per queste sono notevolmente più grandi e il tasso di successo sensibilmente più basso, un risultato che va corretto carattere per carattere non aiuta nessuno. Il greco è incluso, perché sotto questo aspetto non rientra nella stessa categoria.
Il riconoscimento non è mai privo di errori. Ricostruisce dai pixel ciò che un tempo era testo. Una scansione pulita e ben allineata offre risultati molto buoni; una foto storta dal cellulare con luce scarsa, una calligrafia scarabocchiata o un carattere decorativo insolito, risultati decisamente peggiori. Chi riutilizza il testo dovrebbe rileggerlo, vale per qualsiasi OCR, non solo per questo.
L'aspetto della pagina non cambia. Il testo riconosciuto viene posto come strato invisibile sopra l'immagine: continui a vedere la tua scansione, ma puoi cercare e selezionare al suo interno. Gli errori di riconoscimento non sono quindi visibili nell'immagine. Emergono solo quando copi il testo.
L'OCR è utile anche dopo aver compresso un PDF: in quel processo le pagine diventano immagini e perdono il loro livello di testo, il riconoscimento testo lo ricrea.
Domande frequenti
Il mio documento viene caricato per il riconoscimento del testo? +
No. Il riconoscimento avviene interamente nel browser tramite un motore OCR caricato localmente, il file non lascia mai il tuo dispositivo.
Quali lingue sono supportate? +
Un'ampia selezione di lingue europee con scrittura latina o greca. Scritture come cinese, arabo, cirillico o devanagari attualmente non sono supportate per l'OCR.
Quanto dura il riconoscimento? +
A seconda del numero di pagine e delle prestazioni del dispositivo, da alcuni secondi a pochi minuti.
Il riconoscimento del testo cambia l'aspetto della pagina? +
No. L'immagine della pagina resta esattamente uguale, il livello di testo riconosciuto vi giace sopra in modo invisibile, solo ricerca e copia diventano così possibili.
Quanto è buono il riconoscimento con documenti scansionati male o manoscritti? +
Il riconoscimento funziona meglio con testi stampati puliti e ben leggibili. Con note manoscritte o scansioni molto rumorose la precisione diminuisce; singoli caratteri possono essere riconosciuti male o mancare.
Quali lingue vengono riconosciute? +
28, tutte con scrittura latina più il greco. Le scritture non latine come cirillico, cinese, arabo, ebraico o thailandese sono deliberatamente escluse, lì il tasso di successo sarebbe notevolmente peggiore.
Quanto è preciso il riconoscimento? +
Con una scansione pulita e dritta molto buono; con foto storte dal cellulare, luce scarsa o calligrafia, sensibilmente peggiore. Chi riutilizza il testo dovrebbe rileggerlo.
Il mio documento appare diverso dopo il riconoscimento del testo? +
No. Il testo riconosciuto arriva come strato invisibile sopra l'immagine, la pagina appare come prima, ma è ricercabile.
Questo potrebbe aiutarti
Comprimere PDF
Riduci notevolmente PDF con molte immagini, le pagine diventano immagini in questo processo.
Convertire PDF in PDF/A
Converti nel formato PDF/A adatto all'archiviazione, per enti pubblici e conservazione a lungo termine.
Convertire PDF in Word
Esporta il testo PDF come file Word modificabile, senza caricamento.
Modificare il testo PDF
Clicca sul testo esistente nel PDF e sostituiscilo con uno nuovo.