 mousePDF
PDF متن کی شناخت (OCR) — بغیر اپ لوڈ کے
اسکین شدہ یا تصویر کی شکل میں موجود PDF صفحات پر ایک غیر مرئی، قابل تلاش متن کی تہہ بچھائیں۔ شناخت مکمل طور پر آپ کے براؤزر میں چلتی ہے، آپ کی فائل کبھی اپ لوڈ نہیں ہوتی۔
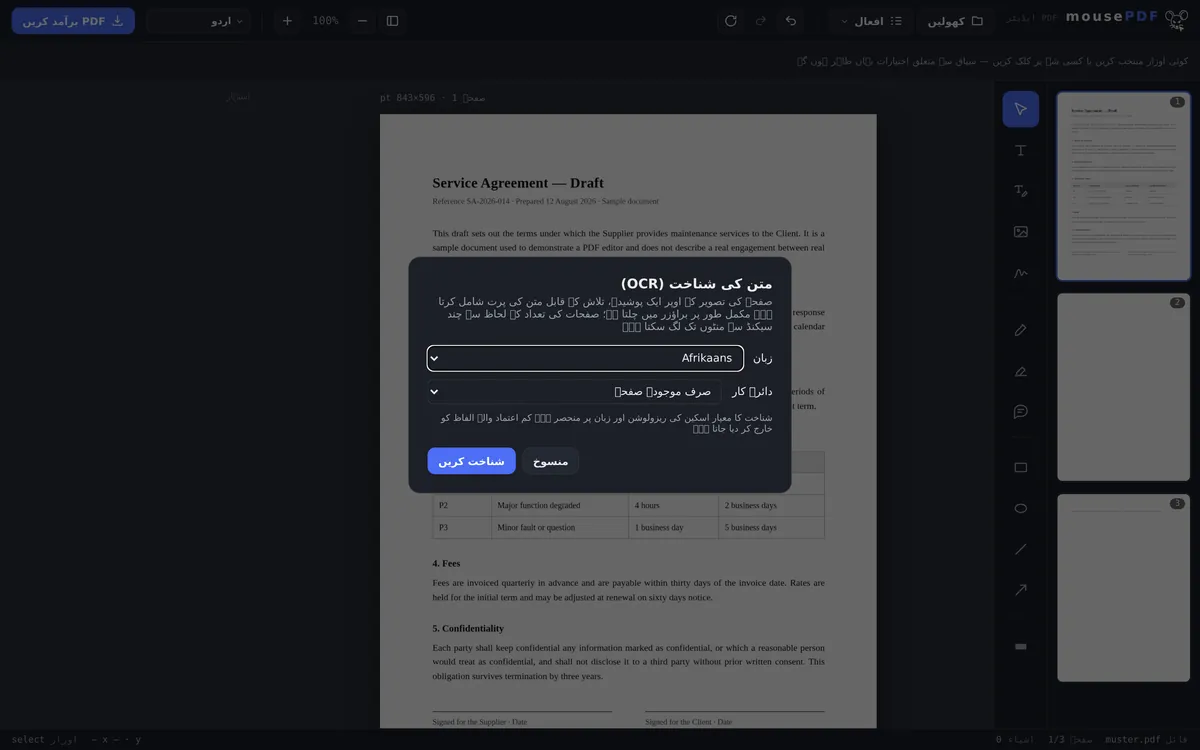
تین مراحل میں
PDF کھولیں
اسکین شدہ یا تصویر پر مبنی PDF کو ونڈو میں گھسیٹ کر لائیں یا منتخب کریں۔
زبان اور دائرہ منتخب کریں
شناخت کے لیے زبان متعین کریں اور طے کریں کہ صرف موجودہ صفحہ پہچانا جائے یا پوری دستاویز۔
ایکسپورٹ کریں
قابل تلاش، غیر مرئی متن کی تہہ کے ساتھ PDF محفوظ کریں — صفحے کی تصویر بصری طور پر بغیر تبدیلی کے رہتی ہے۔
عام صورتحال: اسکین شدہ دستاویزات کو قابل تلاش بنانا
اسکین شدہ معاہدے، رسیدیں یا کتابیں اکثر صرف صفحے کی تصویر رکھتی ہیں، حقیقی متن نہیں — نہ ان میں تلاش ممکن ہے، نہ متن کاپی کیا جا سکتا ہے۔ mousePDF متن کو مقامی طور پر براؤزر میں پہچانتا ہے اور اسے تصویر کے اوپر غیر مرئی طور پر رکھتا ہے، تاکہ تلاش اور کاپی کرنا ممکن ہو جائے، بغیر اس کے کہ صفحے کی ظاہری شکل میں کوئی تبدیلی آئے۔
براؤزر میں متن کی شناخت — اور اس میں خاص کیا ہے
OCR ایسے کاموں میں شامل ہے جن کے لیے عام طور پر کچھ نہ کچھ اپ لوڈ کرنا تقریباً ناگزیر ہوتا ہے: شناخت کے لیے ایک زبان کا ماڈل درکار ہوتا ہے، اور وہ عموماً کسی سرور پر موجود ہوتا ہے۔ یہاں یہ آپ کے براؤزر میں چلتا ہے؛ صرف ماڈل لوڈ ہوتا ہے، کبھی آپ کی فائل نہیں۔
یہ بالکل انہی دستاویزات کے لیے اہم ہے جنہیں اسکین کیا جاتا ہے: معاہدے، تنخواہ کی پرچیاں، ڈاکٹری خط، شناختی کارڈ کی کاپیاں۔ اسکین ایک تصویر ہے — اور قابل تلاش بننے سے پہلے کسی کو اسے پڑھنا ہوتا ہے۔ یہ کہ یہ 'کوئی' آپ کے اپنے آلے پر، آپ کے براؤزر میں چلتا ہے، اصل فرق ہے۔
OCR کے لیے 28 زبانیں دستیاب ہیں۔ منتخب زبان کا ماڈل اصل عمل کے وقت ہی لوڈ کیا جاتا ہے — اس سے صفحہ ہلکا رہتا ہے، اور آپ صرف وہی لوڈ کرتے ہیں جس کی ضرورت ہو۔
شناخت کی حدیں کہاں آتی ہیں
غیر لاطینی رسم الخط جان بوجھ کر شامل نہیں ہیں۔ نہ سیریلک، نہ چینی، جاپانی یا کوریائی، نہ عربی، عبرانی، دیوناگری یا تھائی — اور نہ اردو۔ ان کے ماڈل نمایاں طور پر بڑے ہیں اور کامیابی کی شرح واضح طور پر کم ہے — ایسا نتیجہ جسے حرف بہ حرف درست کرنا پڑے، کسی کے کام نہیں آتا۔ یونانی شامل ہے کیونکہ یہ اس لحاظ سے اسی زمرے میں نہیں آتی۔
شناخت کبھی بھی مکمل طور پر بے خطا نہیں ہوتی۔ یہ پکسلز سے وہ چیز واپس پڑھتی ہے جو کبھی متن تھی۔ ایک صاف، سیدھا اسکین بہت اچھے نتائج دیتا ہے؛ خراب روشنی میں لیا گیا ترچھا موبائل فوٹو، بدخط ہاتھ کی تحریر یا غیر معمولی سجاوٹی فونٹ نمایاں طور پر کمزور نتائج دیتے ہیں۔ جو کوئی متن کو آگے استعمال کرے، اسے دوبارہ پڑھ کر جانچ لینا چاہیے — یہ ہر OCR سے پروسیس شدہ ورژن پر لاگو ہوتا ہے، صرف اس پر نہیں۔
صفحے کی ظاہری شکل تبدیل نہیں ہوتی۔ پہچانا گیا متن تصویر کے اوپر ایک غیر مرئی تہہ کے طور پر رکھا جاتا ہے: آپ اب بھی اپنا اسکین دیکھتے ہیں، لیکن اس میں تلاش اور نشان زدگی کر سکتے ہیں۔ اس لیے شناخت کی غلطیاں تصویر میں نظر نہیں آتیں — وہ تب ظاہر ہوتی ہیں جب آپ متن کاپی کریں۔
OCR PDF کمپریس کرنے کے بعد بھی مفید ہے: اس عمل میں صفحات تصاویر بن جاتے ہیں اور اپنی متن کی تہہ کھو دیتے ہیں — متن کی شناخت اسے نئے سرے سے بناتی ہے۔
عمومی سوالات
کیا میری دستاویز متن کی شناخت کے لیے اپ لوڈ کی جاتی ہے؟ +
نہیں۔ شناخت مکمل طور پر براؤزر میں، مقامی طور پر لوڈ شدہ OCR انجن کے ذریعے چلتی ہے — فائل کبھی آپ کے آلے سے باہر نہیں جاتی۔
کون سی زبانیں معاون ہیں؟ +
لاطینی یا یونانی رسم الخط والی یورپی زبانوں کا ایک وسیع انتخاب۔ چینی، عربی، سیریلک یا دیوناگری جیسے رسم الخط — اور اردو کا رسم الخط بھی — فی الحال OCR کے لیے معاون نہیں ہیں۔
شناخت میں کتنا وقت لگتا ہے؟ +
صفحات کی تعداد اور آلے کی کارکردگی کے مطابق چند سیکنڈ سے چند منٹ تک۔
کیا متن کی شناخت صفحے کی ظاہری شکل بدل دیتی ہے؟ +
نہیں۔ صفحے کی تصویر بالکل ویسی ہی رہتی ہے، پہچانی گئی متن کی تہہ اس کے اوپر غیر مرئی طور پر موجود ہوتی ہے — صرف تلاش اور کاپی کرنا اس سے ممکن ہو جاتا ہے۔
خراب اسکین شدہ یا ہاتھ سے لکھی دستاویزات پر شناخت کتنی اچھی ہوتی ہے؟ +
شناخت صاف چھپے ہوئے، آسانی سے پڑھے جانے والے متن پر سب سے بہتر کام کرتی ہے۔ ہاتھ سے لکھے نوٹس یا شدید طور پر دھندلے اسکینز میں درستگی کم ہو جاتی ہے — تب انفرادی حروف غلط پہچانے جا سکتے ہیں یا غائب ہو سکتے ہیں۔
کون سی زبانیں پہچانی جاتی ہیں؟ +
28، سب لاطینی رسم الخط کے ساتھ، نیز یونانی۔ غیر لاطینی رسم الخط جیسے سیریلک، چینی، عربی، عبرانی یا تھائی — اور اردو کا رسم الخط بھی — جان بوجھ کر شامل نہیں ہیں، کیونکہ ان میں کامیابی کی شرح نمایاں طور پر کم ہوتی۔
شناخت کتنی درست ہوتی ہے؟ +
صاف، سیدھے اسکین پر بہت اچھی؛ ترچھے موبائل فوٹوز، خراب روشنی یا ہاتھ کی تحریر پر نمایاں طور پر کمزور۔ جو متن کو آگے استعمال کرے، اسے دوبارہ جانچ لینا چاہیے۔
کیا میری دستاویز متن کی شناخت کے بعد مختلف نظر آئے گی؟ +
نہیں۔ پہچانا گیا متن تصویر کے اوپر ایک غیر مرئی تہہ کے طور پر آتا ہے — صفحہ پہلے جیسا ہی نظر آتا ہے، لیکن اب قابل تلاش ہے۔
یہ بھی مددگار ہو سکتا ہے
PDF کمپریس کریں
تصویروں سے بھری PDFs کو نمایاں طور پر چھوٹا کریں — اس عمل میں صفحات تصاویر بن جاتے ہیں۔
PDF کو PDF/A میں تبدیل کریں
آرکائیو کے موزوں PDF/A فارمیٹ میں تبدیل کریں — سرکاری اداروں اور طویل مدتی محفوظ کاری کے لیے۔
PDF کو Word میں تبدیل کریں
PDF کے متن کو قابل ترمیم Word فائل کے طور پر ایکسپورٹ کریں — بغیر اپ لوڈ کے۔
PDF متن میں ترمیم کریں
PDF میں موجود متن پر کلک کریں اور اسے نئے متن سے بدلیں۔