 mousePDF
Prepoznavanje besedila v PDF (OCR) — brez nalaganja
Postavite nevidno, iskalno plast besedila čez skenirane ali kot slika prisotne strani PDF. Prepoznavanje poteka v celoti v vašem brskalniku, vaša datoteka se nikoli ne naloži.
V treh korakih
Odprite PDF
Skeniran ali na sliki temelječ PDF povlecite in spustite v okno ali ga izberite.
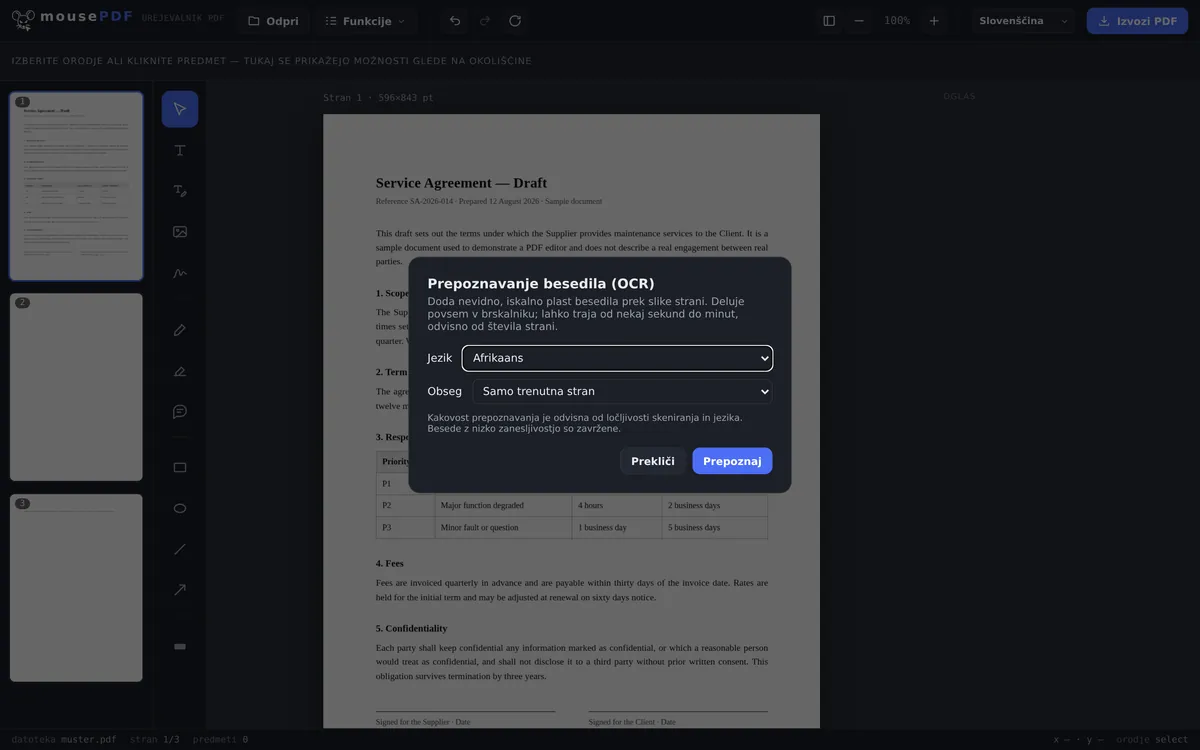
Izberite jezik in obseg
Določite jezik prepoznavanja in se odločite, ali naj se prepozna samo trenutna stran ali celoten dokument.
Izvozite
Shranite PDF z iskalno, nevidno plastjo besedila — slika strani ostane vizualno nespremenjena.
Značilen primer: omogočiti iskanje po skeniranih dokumentih
Skenirane pogodbe, računi ali knjige pogosto vsebujejo le sliko strani, ne pravega besedila — po njih ni mogoče iskati niti kopirati besedila. mousePDF prepozna besedilo lokalno v brskalniku in ga nevidno postavi čez sliko, tako da iskanje in kopiranje delujeta, ne da bi se na videzu strani karkoli spremenilo.
Prepoznavanje besedila v brskalniku — in kaj je pri tem posebnega
OCR sodi med naloge, za katere sicer skoraj nujno nekaj naložite: prepoznavanje potrebuje jezikovni model, ta pa je običajno na strežniku. Tukaj poteka v vašem brskalniku; naloži se samo model, nikoli vaša datoteka.
To je pomembno prav pri dokumentih, ki jih skenirate: pogodbe, plačilne liste, zdravniška poročila, kopije osebnih dokumentov. Sken je slika — in preden je po njej mogoče iskati, jo mora nekaj prebrati. Da to nekaj teče na vaši lastni napravi v vašem brskalniku, je prava razlika.
Na voljo je 28 jezikov za OCR. Model izbranega jezika se naloži šele ob dejanski uporabi — stran zato ostane lahka, naložite pa le tisto, kar potrebujete.
Kje prepoznavanje naleti na svoje meje
Nelatinske pisave namenoma manjkajo. Ni cirilice, ni kitajščine, japonščine ali korejščine, ni arabščine, hebrejščine, devanagarija ali tajščine. Modeli zanje so precej večji, natančnost pa opazno nižja — rezultat, ki ga je treba popravljati znak za znakom, ne pomaga nikomur. Grščina je vključena, ker v tem pogledu ne sodi v isti razred.
Prepoznavanje nikoli ni brez napak. Iz slikovnih pik bere nazaj, kaj je nekoč bilo besedilo. Čist sken z ravno usmerjenostjo prinese zelo dobre rezultate; postrani fotografija s telefonom pri slabi svetlobi, čačkasta pisava ali nenavadna okrasna pisava pa opazno slabše. Kdor besedilo nadalje uporablja, naj ga preveri — to velja za vsako z OCR obdelano različico, ne le za to.
Videz strani se ne spremeni. Prepoznano besedilo se postavi kot nevidna plast čez sliko: še naprej vidite svoj sken, lahko pa po njem iščete in ga označujete. Napake pri prepoznavanju zato v sliki niso vidne — pokažejo se šele, ko besedilo skopirate ven.
OCR je uporaben tudi po stiskanju PDF-ja: pri tem strani postanejo slike in izgubijo svojo plast besedila — prepoznavanje besedila jo ustvari na novo.
Pogosta vprašanja
Ali se moj dokument za prepoznavanje besedila naloži? +
Ne. Prepoznavanje poteka v celoti v brskalniku prek lokalno naloženega mehanizma OCR — datoteka nikoli ne zapusti vaše naprave.
Kateri jeziki so podprti? +
Večji izbor evropskih jezikov z latinico ali grško pisavo. Pisave, kot so kitajščina, arabščina, cirilica ali devanagari, trenutno niso podprte za OCR.
Koliko časa traja prepoznavanje? +
Odvisno od števila strani in zmogljivosti naprave nekaj sekund do nekaj minut.
Ali prepoznavanje besedila spremeni videz strani? +
Ne. Slika strani ostane popolnoma enaka, prepoznana plast besedila leži nevidno čez njo — omogoči le iskanje in kopiranje.
Kako dobro deluje prepoznavanje pri slabo skeniranih ali rokopisnih dokumentih? +
Prepoznavanje deluje najbolje pri čisto natisnjenem, dobro berljivem besedilu. Pri rokopisnih opombah ali močno zašumljenih skenih se natančnost zniža — takrat so lahko posamezni znaki napačno prepoznani ali manjkajo.
Kateri jeziki so prepoznani? +
28, vsi z latinico plus grščina. Nelatinske pisave, kot so cirilica, kitajščina, arabščina, hebrejščina ali tajščina, namenoma niso vključene — natančnost bi bila tam precej slabša.
Kako natančno je prepoznavanje? +
Pri čistem, ravnem skenu zelo dobro; pri postrani fotografijah s telefonom, slabi svetlobi ali rokopisu opazno slabše. Kdor besedilo nadalje uporablja, naj ga preveri.
Ali je moj dokument po prepoznavanju besedila videti drugače? +
Ne. Prepoznano besedilo pride kot nevidna plast čez sliko — stran je videti kot prej, po njej pa je mogoče iskati.
To bi vam lahko tudi pomagalo
Stiskanje PDF
Znatno pomanjšajte datoteke PDF z veliko slikami — strani pri tem postanejo slike.
Pretvorba PDF v PDF/A
Pretvorite v arhivsko primeren format PDF/A — za organe in dolgoročno hranjenje.
Pretvorba PDF v Word
Izvozite besedilo PDF kot urejljivo datoteko Word — brez nalaganja.
Urejanje besedila v PDF
Kliknite obstoječe besedilo v PDF-ju in ga nadomestite z novim.